Mesh-LLM/mesh-llm
Rust4 / 0
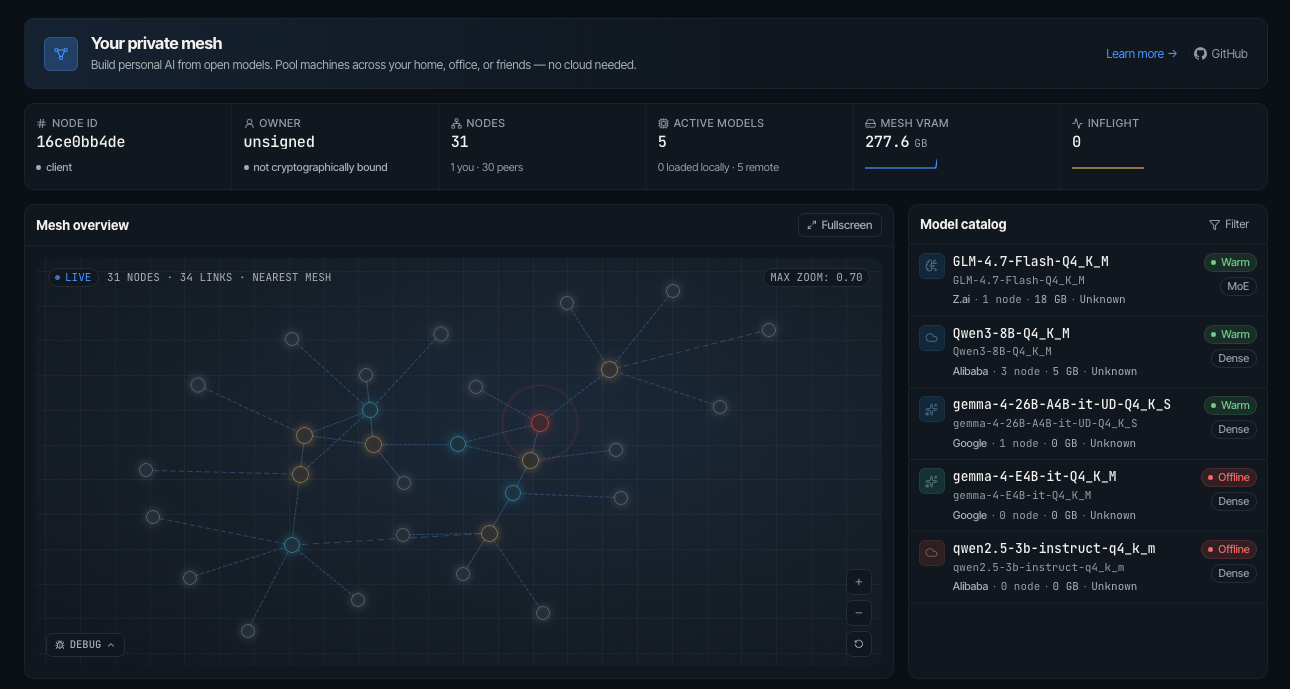
Mesh LLM은 로컬과 원격 머신의 GPU·메모리를 풀링해 OpenAI 호환 로컬 API로 분산 추론을 제공하는 소프트웨어이다.
TL;DR
Mesh LLM은 여러 대의 로컬·원격 머신에서 GPU와 메모리를 풀링해 단일 OpenAI 호환 /v1 API로 노출하는 분산 추론 메쉬 소프트웨어이다. 시스템은 우선 단일 머신 적합성을 확인하고 가능 시 로컬에서 모델을 실행하며, 한 머신에 맞지 않는 대형 모델은 Skippy 단계 분할과 레이어 패키지로 분산해 실행한다. 퍼블릭 메쉬는 Nostr를 통해 발견 가능하며 사설 메쉬는 초대 토큰으로 제어하므로 공개성과 프라이버시를 병행할 수 있다. 설치는 릴리스 번들 또는 제공된 설치 스크립트로 가능하고 serve --auto 명령으로 자동 참가와 웹 콘솔 기동이 지원되며, 운영자는 /v1 엔드포인트로 기존 OpenAI 클라이언트를 그대로 활용할 수 있다. 운영 환경별로 CUDA/ROCm/Vulkan 같은 플랫폼별 의존성과 빌드 도구(just, cmake, Rust, Node.js)가 필요하다는 점이 고려사항이다.
핵심 포인트
- OpenAI 호환 API를 노드 전반에 동일하게 노출한다. 이 설계는 기존 OpenAI 클라이언트와의 호환성을 유지해 추가 통합 비용을 줄이며, 클라이언트는 모델이 로컬인지 원격인지 신경 쓰지 않고 표준 엔드포인트에 요청을 보낼 수 있다. 동일한 API 표준은 멀티벤더 환경에서 운영 일관성을 제공한다.
- Skippy 단계 분할과 레이어 패키지로 대형 모델을 분산 실행한다. 코디네이터가 연속된 레이어 범위를 계획해 하위 단계를 먼저 기동하고 준비 완료 후 상위 경로를 공개하는 순서를 지키므로 단계별 준비와 인계가 안전하게 이루어진다. 이 방법은 전체 모델을 하나의 노드에 맞추지 않고도 추론을 가능하게 하는 분산 실행 메커니즘을 제공한다.
- 퍼블릭 발견에 Nostr를 활용하면서 사설은 초대 토큰을 유지해 보안과 가용성 옵션을 병행한다. 공개 메쉬 참여를 쉽게 만들되, 운영자는 초대 기반 사설 메쉬로 접근을 제한할 수 있어 사용 시 보안 요구에 맞춰 선택할 수 있다. 이 구조는 공개 기여와 내부 운용의 균형을 맞추는 설계적 선택이다.
- 풀링된 리소스로 모델을 실행한다. Mesh LLM은 여러 머신의 GPU와 메모리를 하나의 논리적 리소스로 결합해 요청을 처리하며 이 과정에서 각 노드의 용량에 따라 모델을 로컬에 배치하거나 피어로 라우팅한다. 이 접근은 단일 머신 용량을 넘어서는 모델도 분산 환경에서 운영 가능하게 만든다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
| supported_model_families | reviewed_and_certified_rows | 72 P0/P1 reviewed rows, 89 certified rows | — |
이미지 분석
2.5k
STARS
301
FORKS
+210
TRENDING
4
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

