headroomlabs-ai/headroom
Headroom은 에이전트가 읽는 모든 컨텐츠를 로컬에서 가역적으로 압축해 토큰 비용을 대폭 줄이되 정확도는 유지하는 프록시·라이브러리·MCP 솔루션이다.
TL;DR
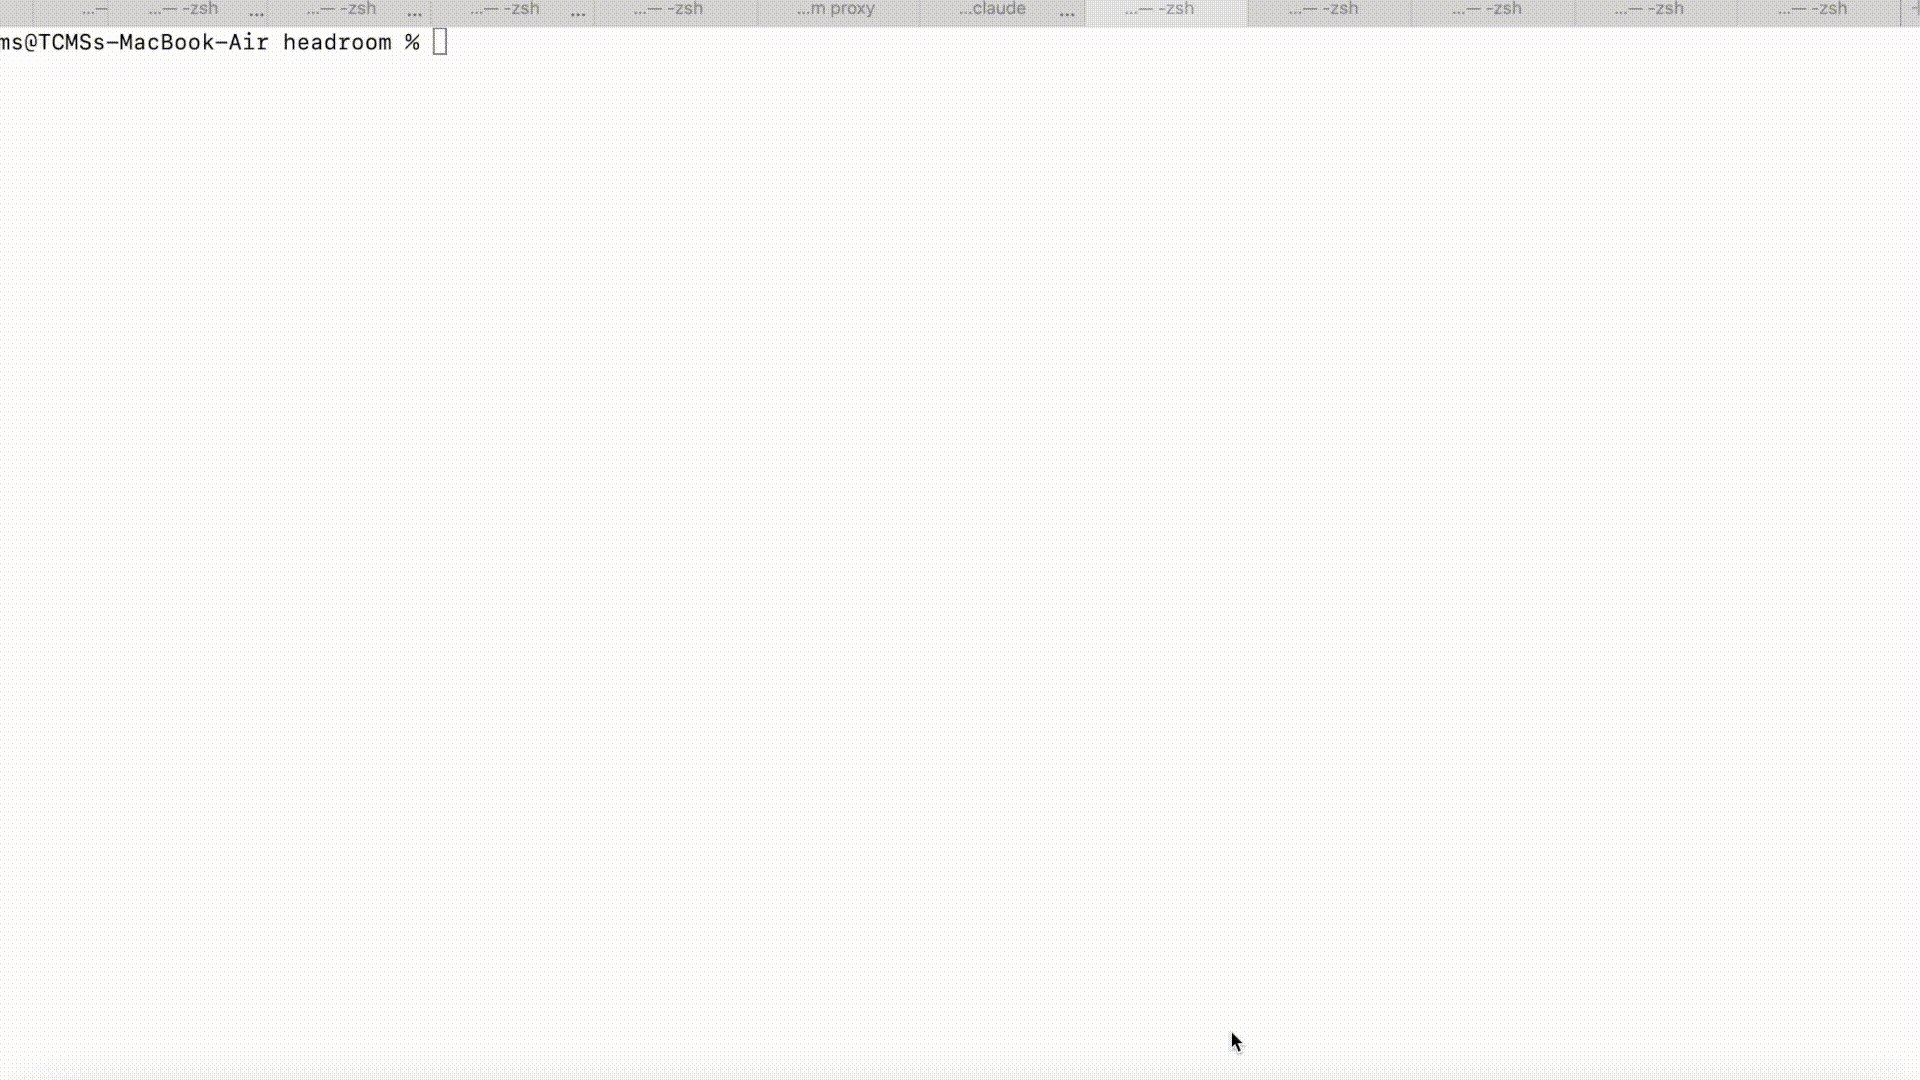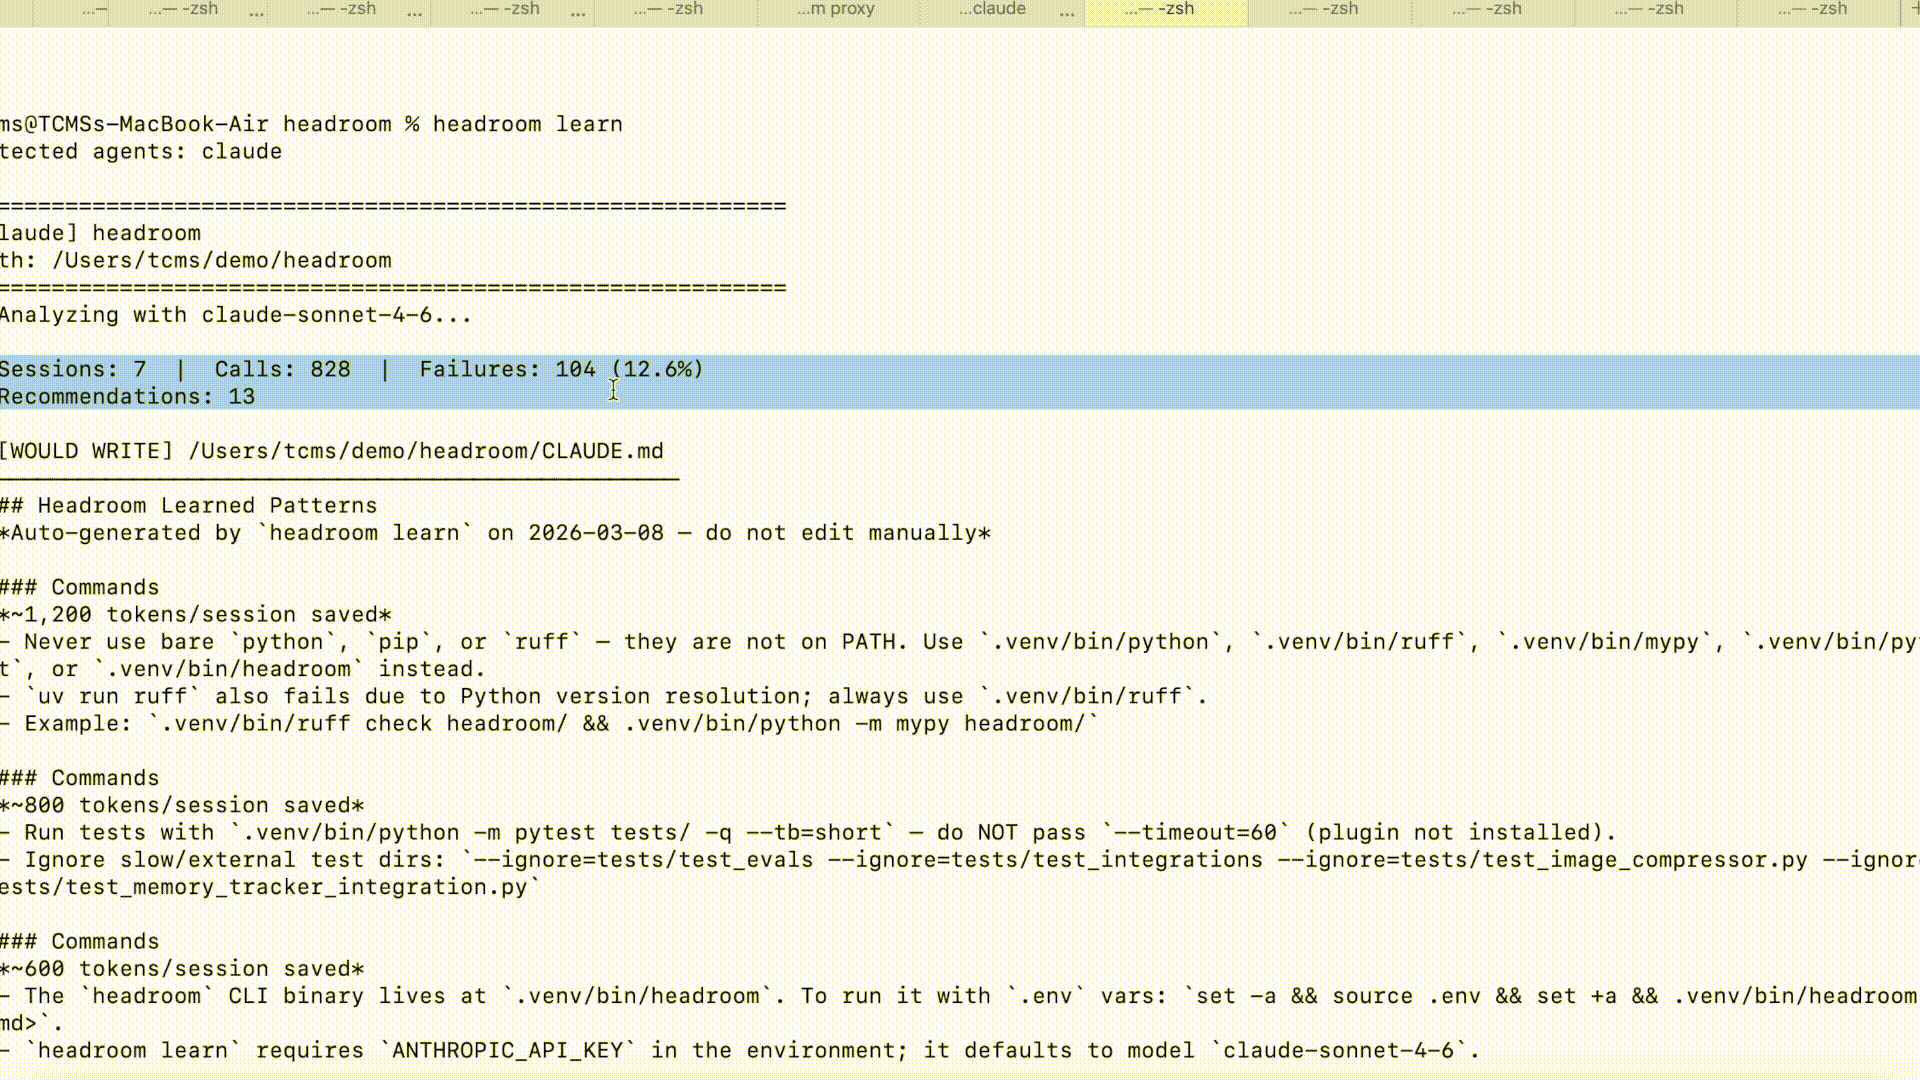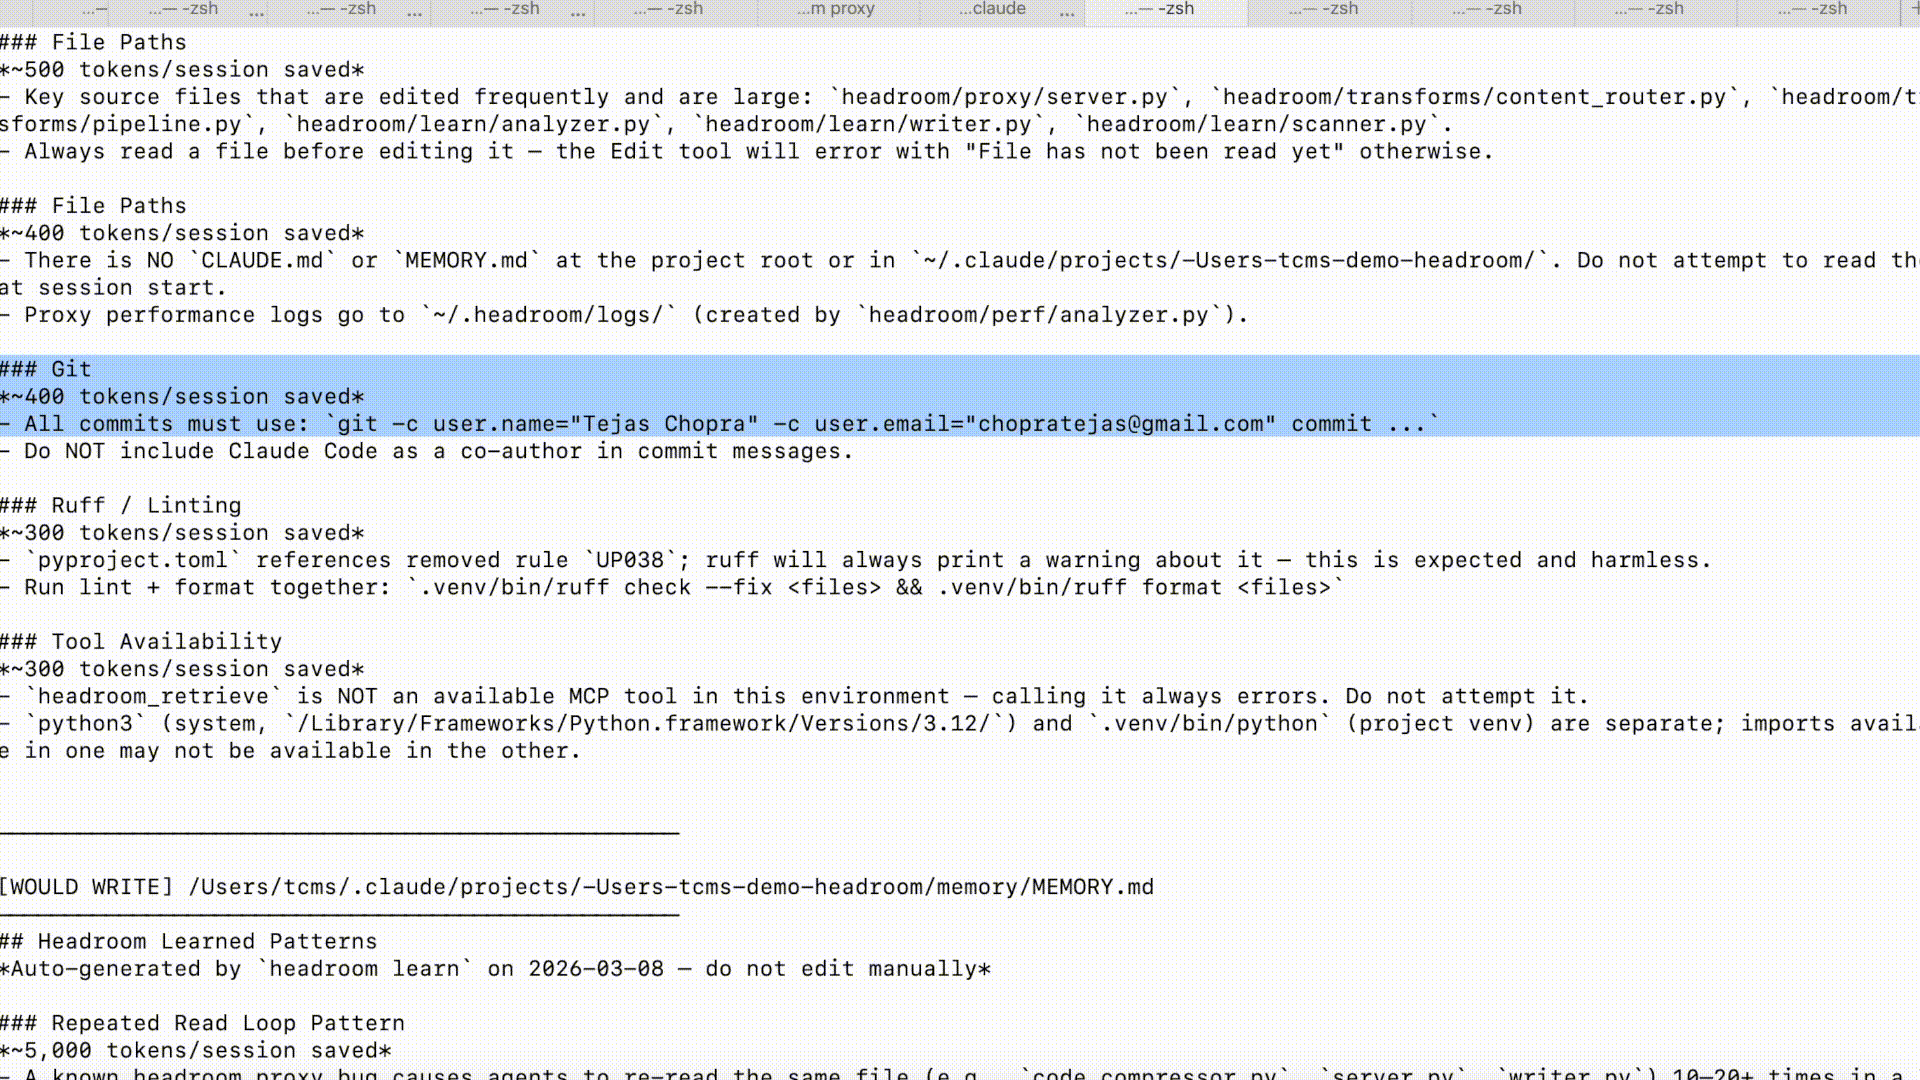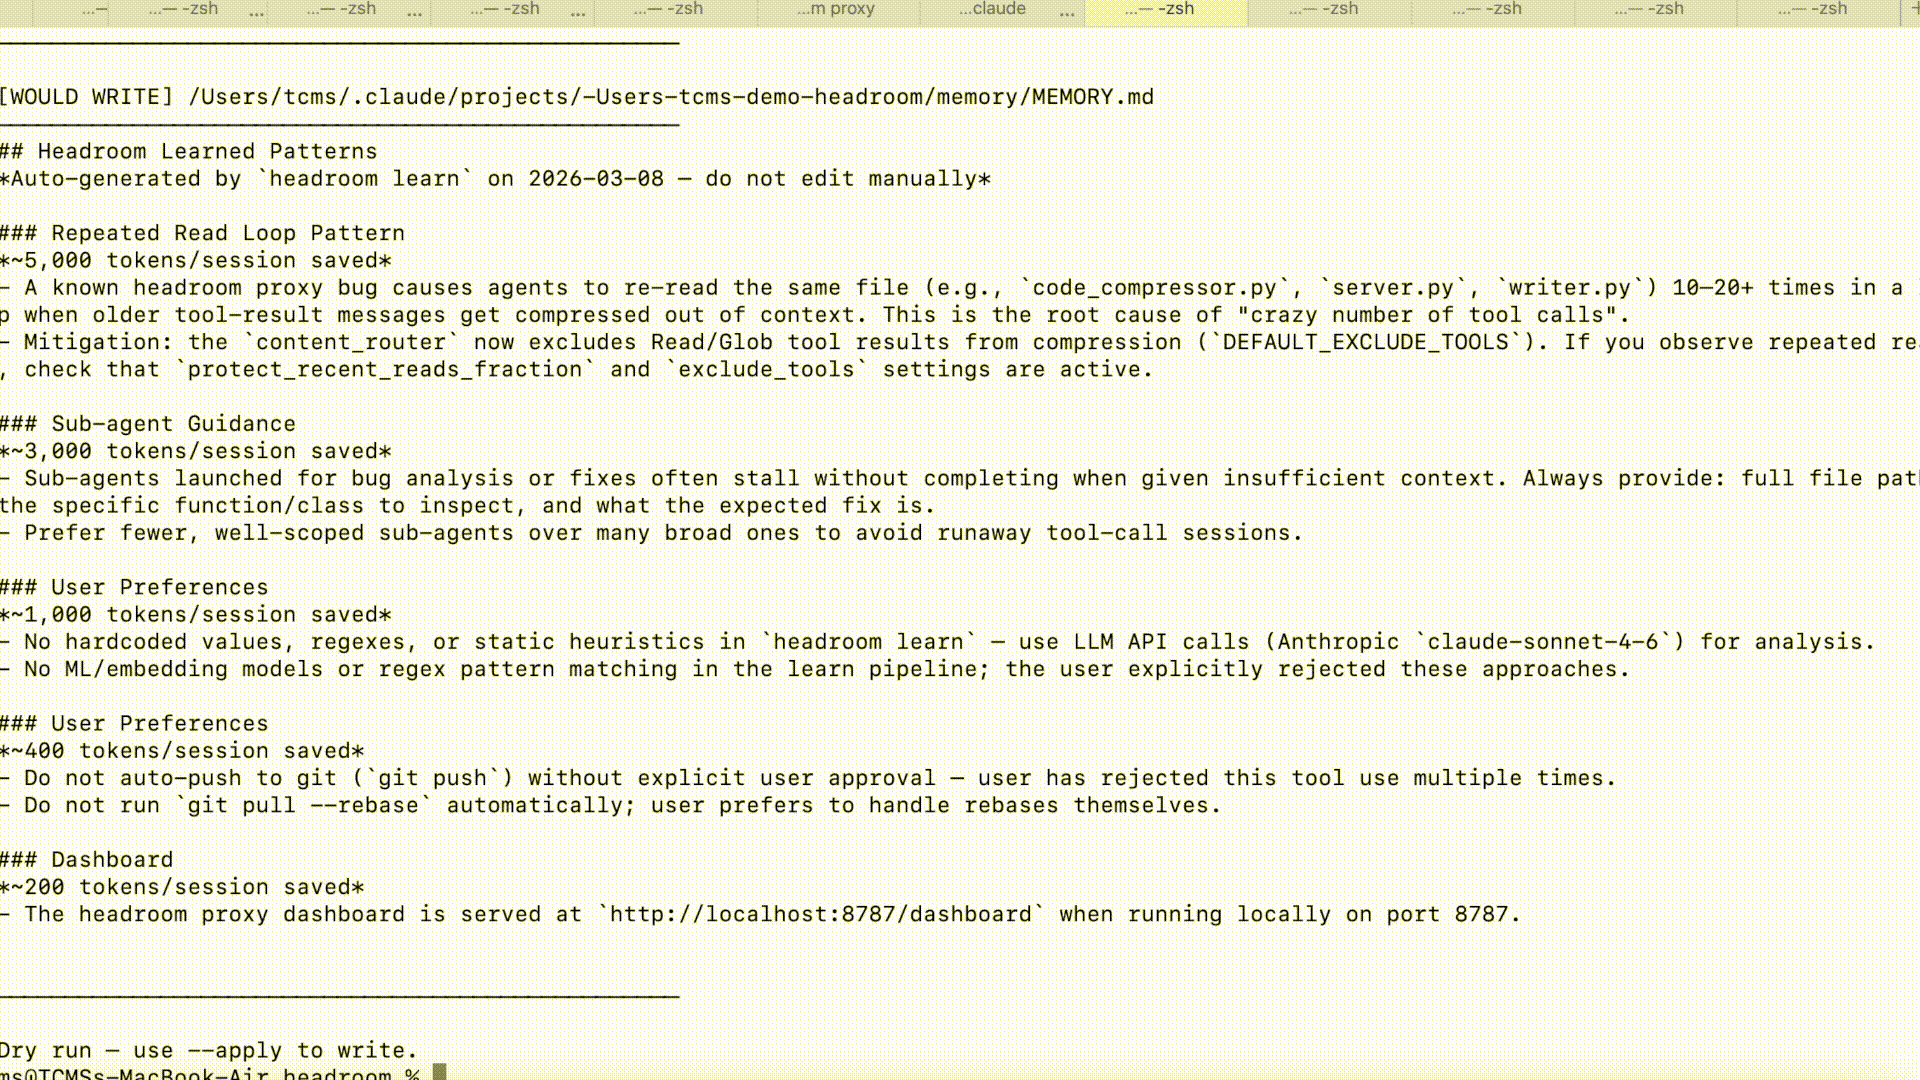
Headroom은 AI 에이전트가 읽는 모든 형태의 컨텐츠를 로컬에서 분류하고 유형별 압축기를 적용해 전송 및 출력 토큰을 줄이는 인프라 솔루션이다. 프록시·라이브러리·MCP 서버 형태로 제공되며 CacheAligner, ContentRouter, SmartCrusher, CodeCompressor, Kompress-base, CCR 같은 구성 요소로 파이프라인을 구성해 입력을 압축하고 원본을 필요 시 복원할 수 있게 한다. 문서와 데모는 코드 검색, 사고 대응, 이슈 분류 같은 실제 워크로드에서 47–92% 수준의 입력 토큰 절감 사례를 제시한다. 출력 토큰 절감 기능은 프록시 레벨에서 모델의 불필요한 서술과 코드 재출력을 줄이는 방식으로 동작하며, 추정치와 통제군을 통해 절감량을 측정하도록 설계되었다. 'headroom learn' 같은 자동 실패 마이닝 도구가 포함되어 있으므로 실사용 로그 기반으로 적정한 응답 장단을 학습해 런타임 설정을 조정할 수 있다. 또한 Kompress-base 모델은 HuggingFace에서 제공되며 로컬 실행과 원격 허브 사용을 모두 지원한다. 제약은 런타임 자산(ONNX, Kompress 모델 등)과 플랫폼 요구사항이 존재하고 기업 네트워크에서는 TLS/CA 설정 같은 설치 전 검토가 필요하다는 점이다. 로컬 실행과 가역성은 데이터 유출 위험을 낮추지만 로컬 자원과 초기 설정이 필요하며, 일부 기능은 특정 Python 버전(예: 3.10+)과 선택적 런타임 의존성을 요구한다. 문서는 설치·평가·벤치마크 재현을 위한 명령과 측정 방법을 제공하므로 도입 전 실제 워크로드로 성능을 검증할 수 있다.
핵심 포인트
- 로컬 실행과 가역성 조합은 Headroom의 핵심 차별점이며 원본을 CCR로 저장하여 필요 시 LLM이 원본을 조회하도록 복원이 가능하게 만든다. 이 구성은 호스팅형 컴팩션 서비스와 달리 데이터가 외부로 나가지 않는 요구사항을 만족한다. 또한 로컬 캐시 정렬(CacheAligner)을 통해 프롬프트 캐시 적중률을 개선하는 점이 다른 도구와 구분된다.
- 입력 유형별로 특화된 압축기 세트를 제공한다는 점이 실무적 장점으로 작용한다. SmartCrusher는 복잡한 JSON 구조를, CodeCompressor는 AST를 기반으로 한 코드 압축을, Kompress-base는 학습 기반 텍스트 압축을 각각 담당하여 단일 방식보다 높은 절감 효과를 낸다. 이 모듈화는 필요에 따라 개별 압축기만 선택해 사용하거나 플러그인 방식으로 확장할 수 있게 한다.
- 프록시 래핑·CLI·라이브러리·MCP 서버 등 다양한 배포 인터페이스를 동시에 제공해 통합 난이도를 낮춘다. 기존 클라이언트는 프록시 주소만 바꾸면 되고 개발자는 compress() 함수를 호출해 인라인으로 사용 가능하다. 이로 인해 코드 변경 없이 빠르게 비용 절감 효과를 얻을 수 있다.
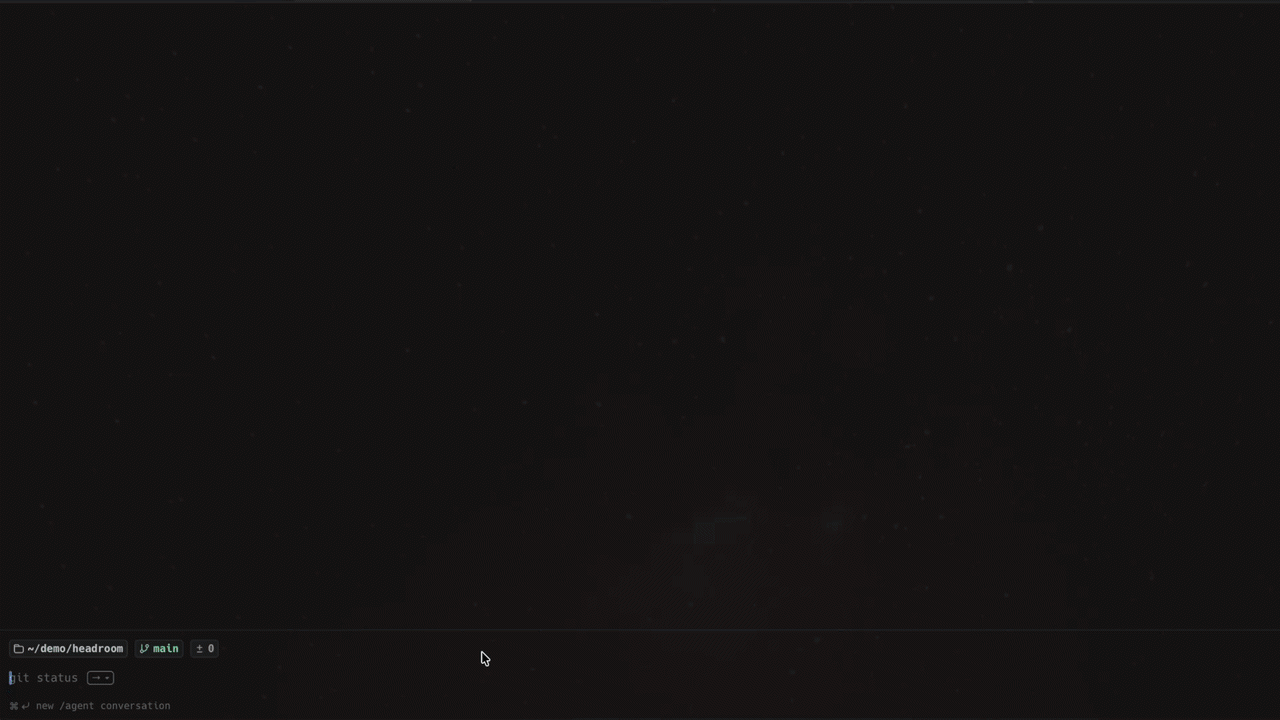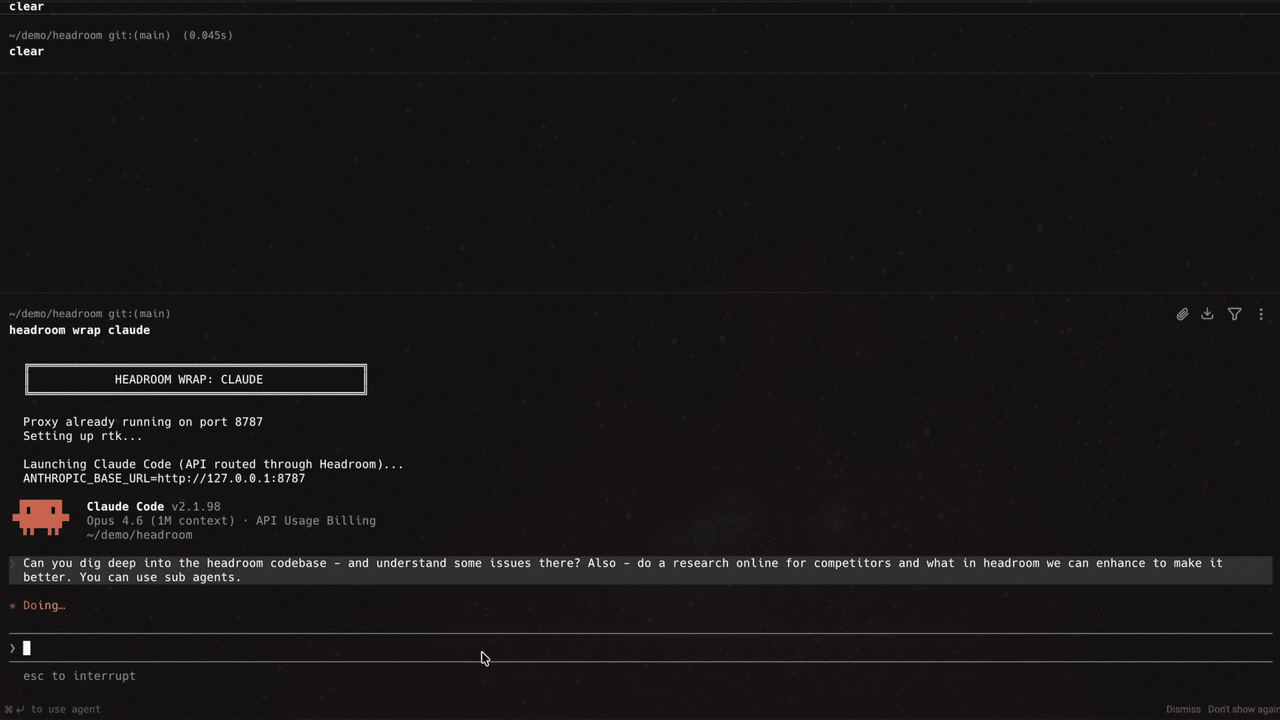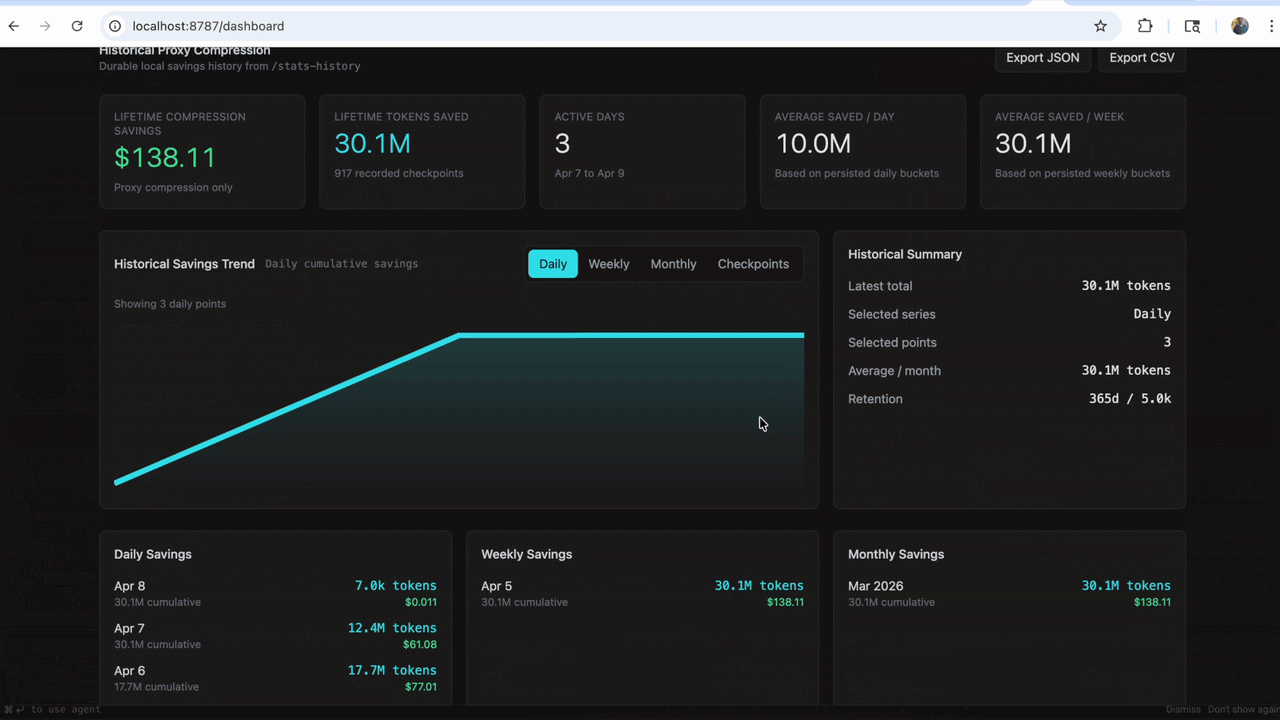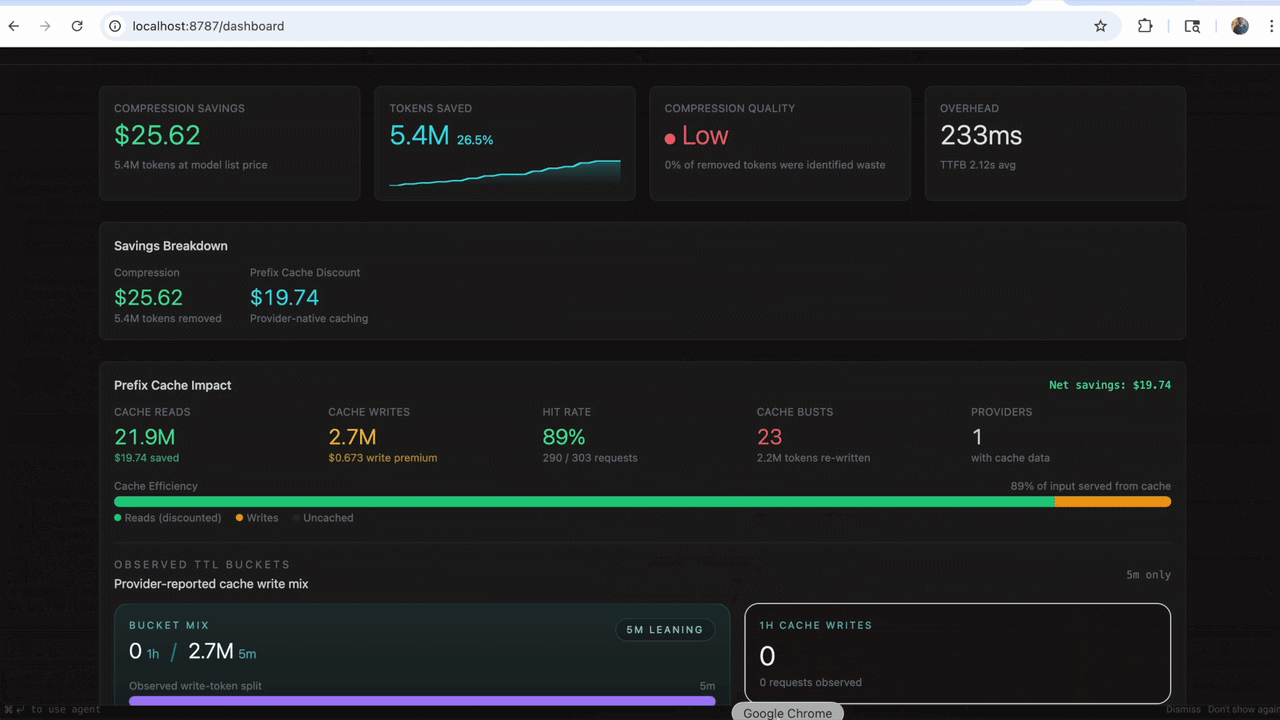
- 프록시와 라이브러리 양쪽 모드로 동작하며 프록시는 네트워크 수준에서 기존 클라이언트의 요청을 중계해 코드 변경 없이 압축 파이프라인을 적용할 수 있다. 프록시는 런타임 설정을 핫-싱크하여 재시작 없이 환경변수 변경을 반영할 수 있으며 대시보드와 성능 측정 도구를 통해 실시간 절감 효과를 확인할 수 있다. 또한 MCP 명령어 셋을 제공해 표준화된 방식으로 압축·복원·통계 API를 노출한다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
| Code search (100 results) | tokens | 17,765 → 1,408 (92% savings) | — |
| SRE incident debugging | tokens | 65,694 → 5,118 (92% savings) | — |
| GitHub issue triage | tokens | 54,174 → 14,761 (73% savings) | — |
| Codebase exploration | tokens | 78,502 → 41,254 (47% savings) | — |
| GSM8K | accuracy | Baseline 0.870 → Headroom 0.870 | Δ ±0.000 |
| TruthfulQA | accuracy | Baseline 0.530 → Headroom 0.560 (N=100) | Δ +0.030 |
| SQuAD v2 | accuracy | Headroom 97% (19% compression) | — |
이미지 분석
52k
STARS
3.7k
FORKS
+265
TRENDING
0
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

