jundot/omlx
Python2 / 0
Apple Silicon용 MLX 추론 서버와 RAM·SSD KV cache를 함께 제공
TL;DR
oMLX는 Apple Silicon Mac에서 MLX 모델을 서비스하는 독립형 LLM inference server이며, macOS 메뉴 막대 앱과 CLI로 관리합니다. FastAPI 기반 OpenAI·Anthropic 호환 API, Continuous batching, RAM·SSD 이중 KV cache를 결합해 여러 모델과 긴 context 요청을 처리합니다. LLM뿐 아니라 VLM, OCR, embedding, reranker를 지원하고 LRU eviction, TTL, pinning으로 메모리를 관리합니다. macOS 15.0 이상과 Apple Silicon이 필수이며, 특정 모델 계열의 native custom kernel 성능을 원하면 full Xcode나 공식 DMG가 필요합니다.
핵심 포인트
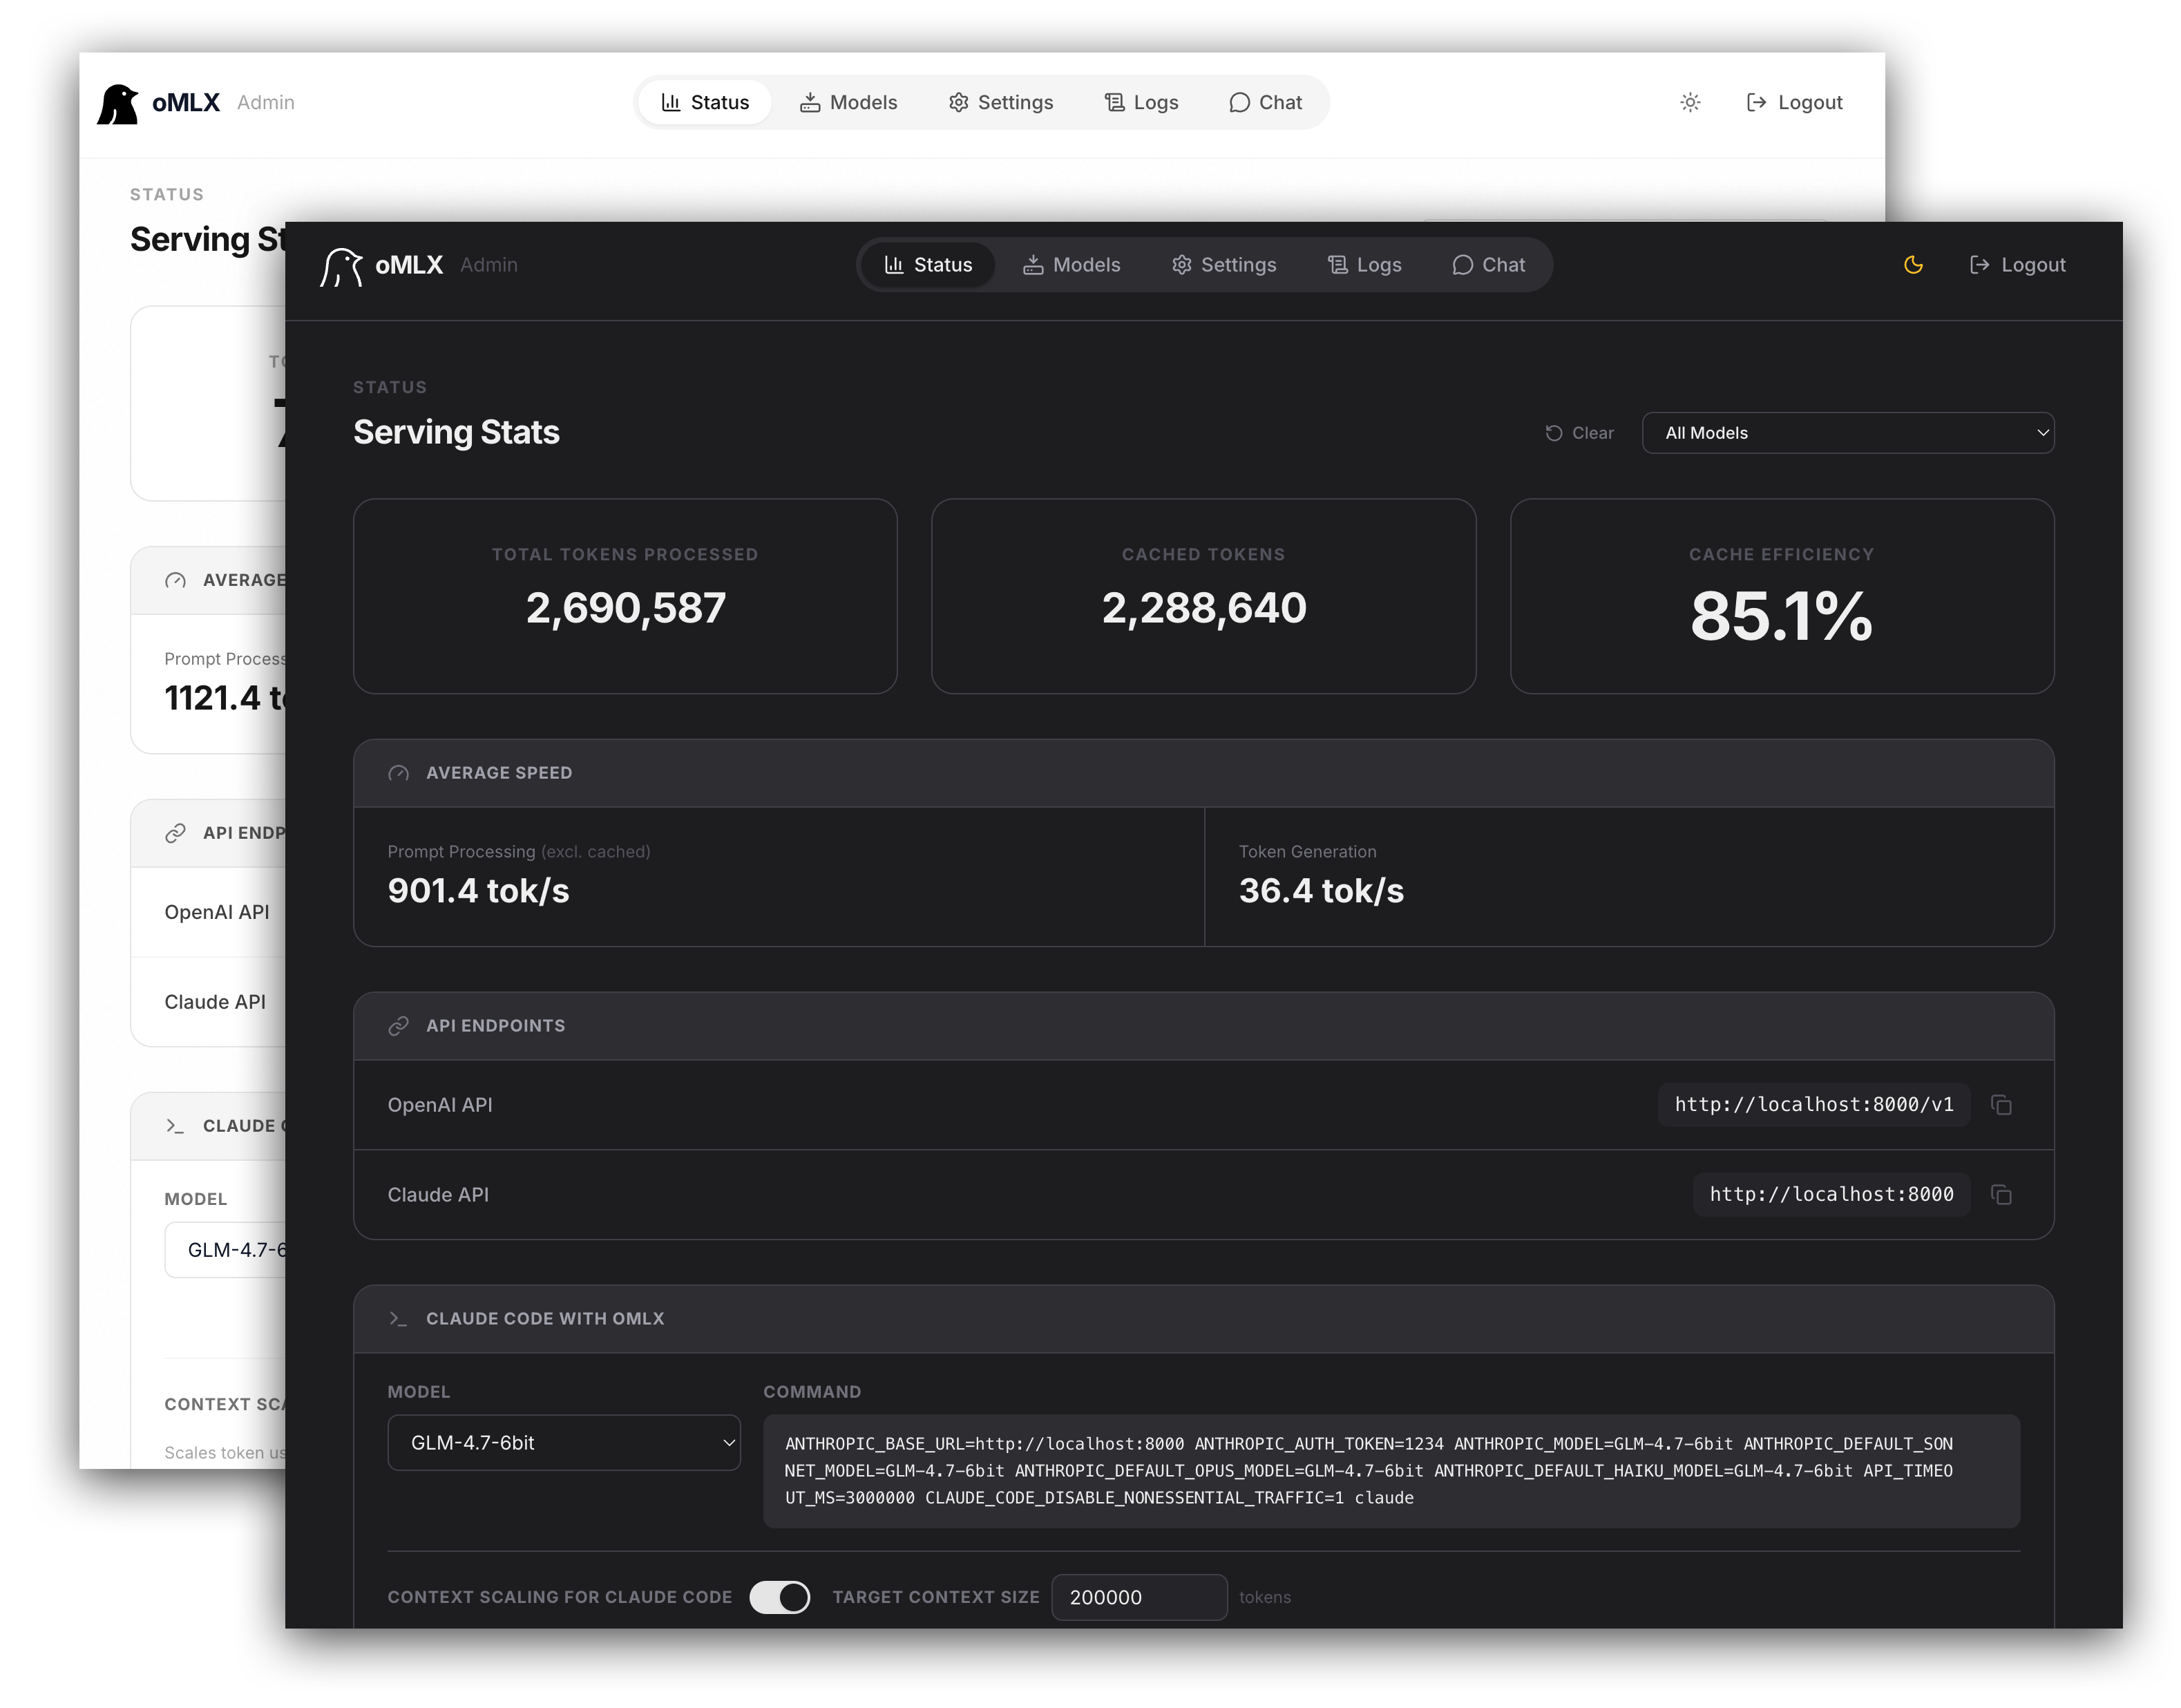
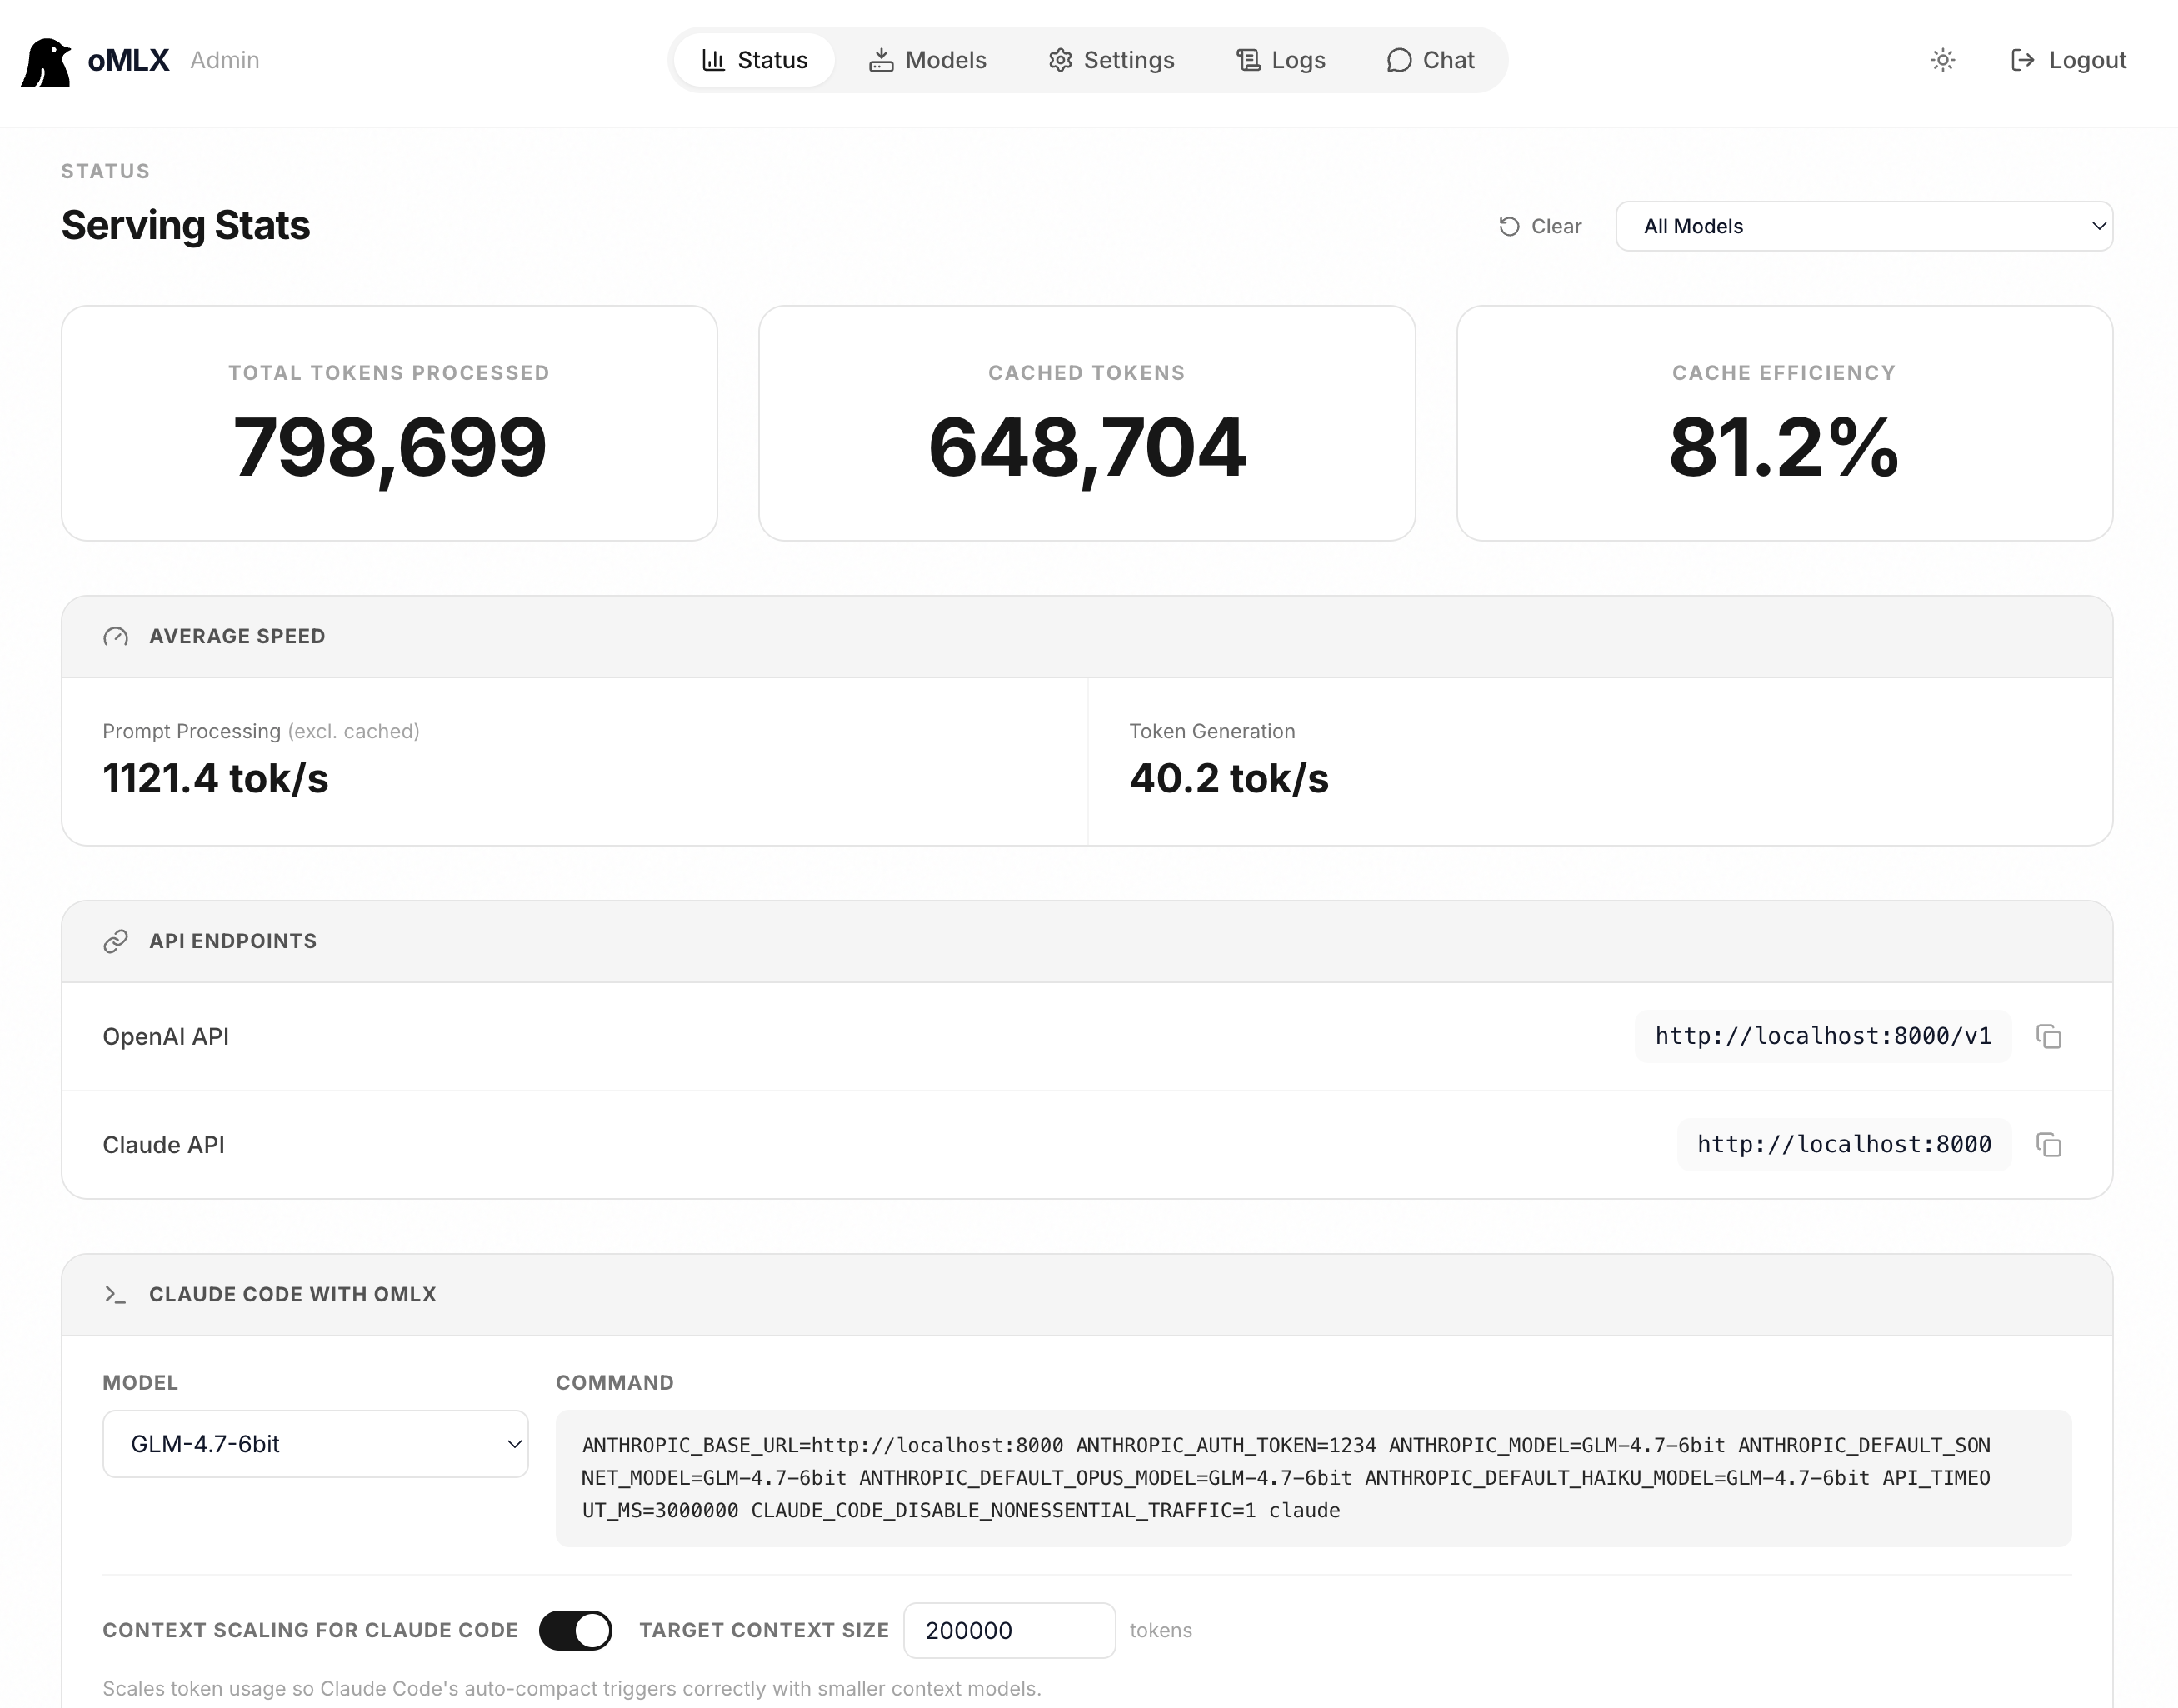
- oMLX는 Apple Silicon Mac에서 MLX 기반 LLM 추론 서버를 실행하는 독립형 도구이며, macOS 메뉴 막대 앱과 CLI를 함께 제공합니다. FastAPI 서버가 OpenAI API와 Anthropic Messages API 호환 엔드포인트를 열어 기존 클라이언트와 연결됩니다. Claude Code, OpenClaw, OpenCode, Codex, Hermes Agent, Copilot, Pi 같은 도구를 관리자 화면에서 연동할 수 있습니다.
- 긴 대화에서 반복되는 prefix를 block 단위 KV cache로 저장하고, 자주 쓰는 블록은 RAM의 Hot tier에 두며 용량이 부족하면 SSD의 Cold tier로 내보냅니다. 다음 요청에서 동일한 prefix를 찾으면 SSD의 safetensors 캐시를 복원해 서버 재시작 뒤에도 전체 context를 다시 계산하지 않습니다. Continuous batching은 mlx-lm의 BatchGenerator를 사용해 여러 요청을 함께 처리하며 동시 요청 수를 설정할 수 있습니다.
- 한 서버에서 LLM, VLM, OCR, embedding, reranker 모델을 자동 탐색하고 필요할 때만 로드할 수 있습니다. 메모리가 부족하면 LRU eviction과 모델별 TTL로 유휴 모델을 내리고, 자주 쓰는 모델은 pinning으로 유지하며 전체 메모리 제한으로 시스템 OOM을 막습니다. 모델별 sampling, alias, chat template kwargs, profile을 관리자 화면에서 즉시 바꿀 수 있어 여러 용도의 설정을 같은 엔진에 겹쳐 사용할 수 있습니다.
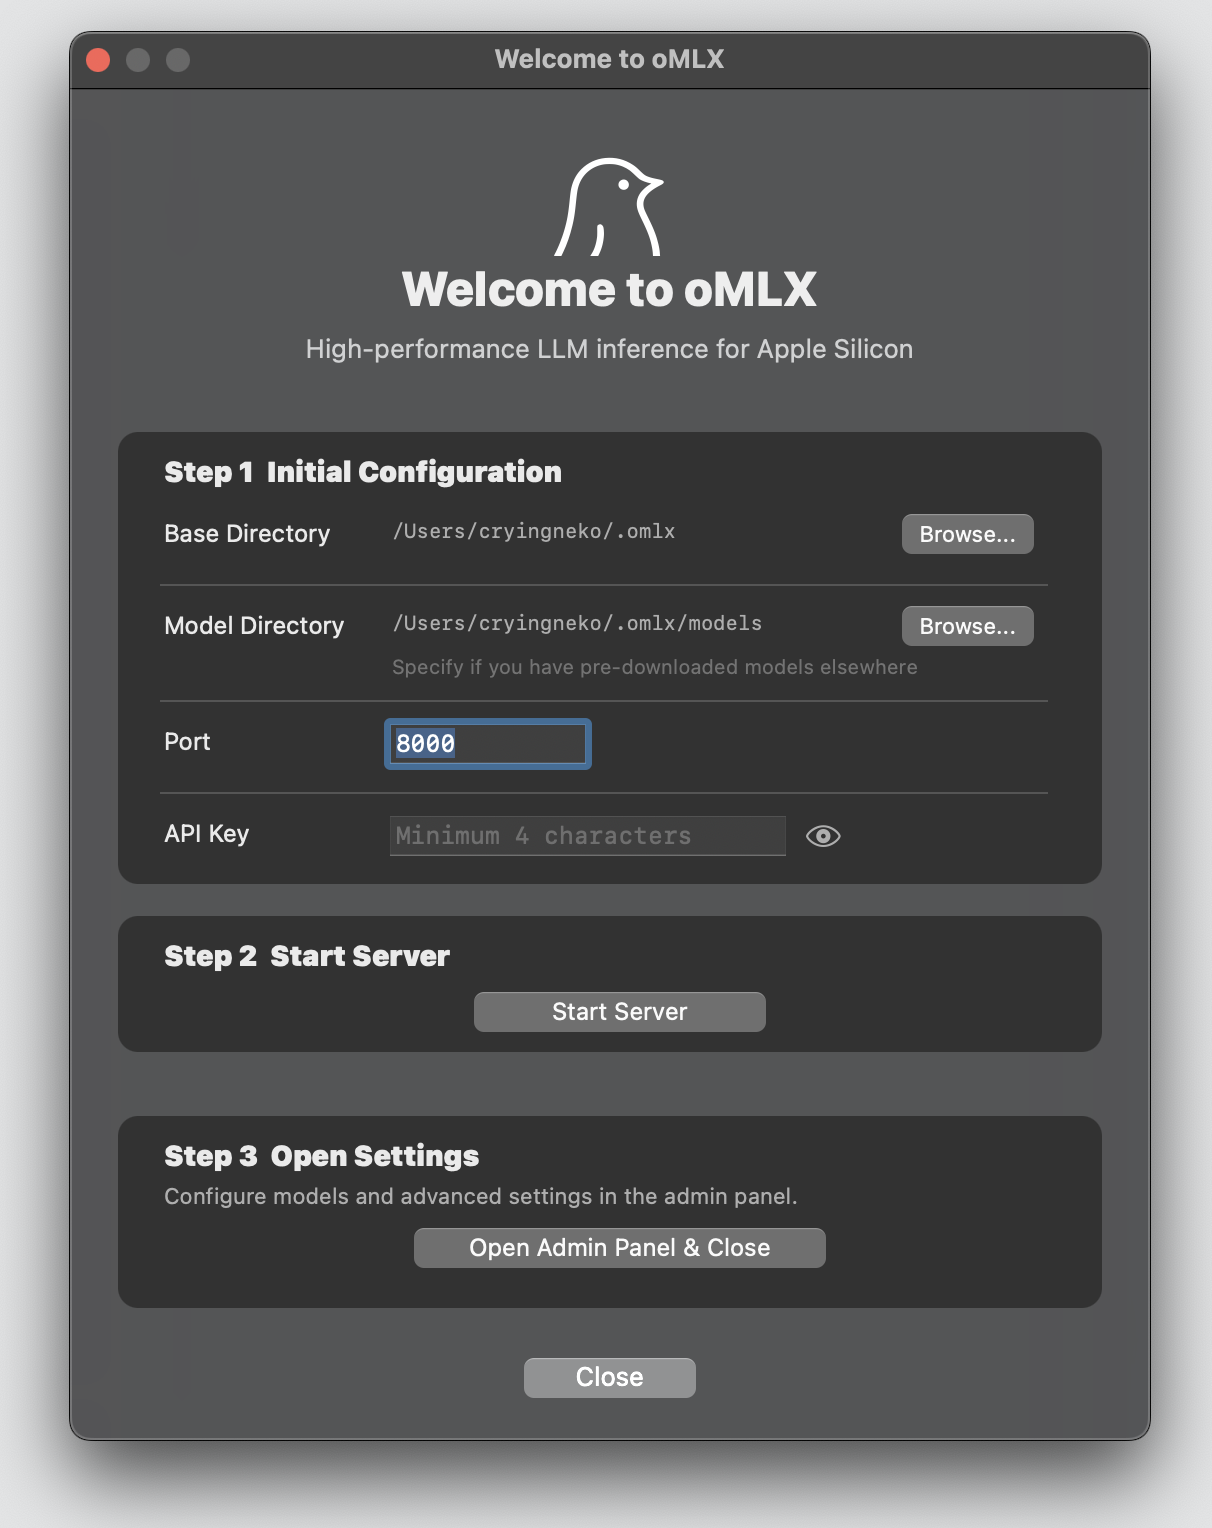
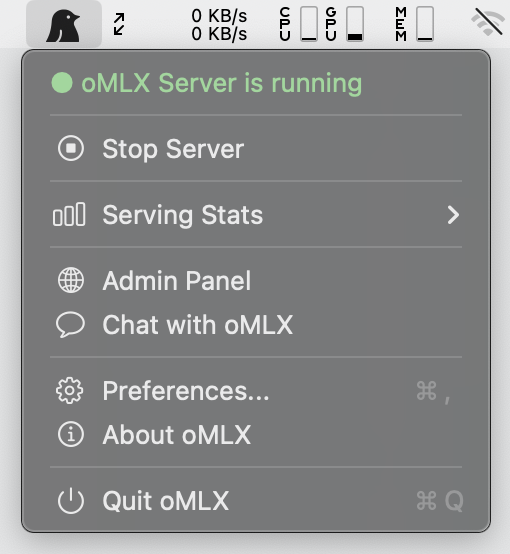
- 대상 환경은 macOS 15.0 이상, Python 3.11–3.13, Apple Silicon M1/M2/M3/M4로 한정됩니다. DMG를 설치하면 메뉴 막대에서 서버 시작·중지·상태 확인과 자동 업데이트를 사용할 수 있고, Homebrew나 소스 설치에서는 omlx CLI와 brew services를 이용합니다. GLM-5.2, MiniMax M3, Qwen3.5 계열은 Metal 기반 native custom kernel을 별도로 빌드하거나 공식 DMG를 사용해야 하며, 그렇지 않으면 훨씬 느린 generic path로 조용히 전환됩니다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
| GLM-5.2 native kernel fused DSA prefill | 처리 속도 | 845 tok/s | M3 Ultra에서 측정된 공개 수치이며, native kernel 미사용 시 약 29 tok/s로 대략 30배 빠름 |
이미지 분석
20.5k
STARS
1.7k
FORKS
+204
TRENDING
2
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

