vectorize-io/hindsight
Python4 / 0
LLM 기반 사실 추출과 다중 검색으로 에이전트의 장기 기억을 구축하는 Python 프레임워크
TL;DR
Hindsight는 대화 이력을 저장하는 수준을 넘어 Agent가 시간이 지나며 사실과 경험을 통합하도록 만든 standalone agent memory framework이다. retain 단계에서 LLM이 사실·Entity·관계를 추출하고, recall 단계에서 Semantic·Keyword·Graph·Temporal 검색을 병렬 수행한 뒤 결과를 재정렬한다. reflect와 Observation·Mental Model 기능은 축적된 근거에서 새로운 연결과 지속적인 답변을 만들도록 설계됐다. Docker, Embedded DB, Helm, SDK, MCP, 60개 이상의 통합을 제공하므로 장기 기억이 필요한 운영형 Agent에 적합하지만 단순 검색형 워크플로에는 무거울 수 있다.
핵심 포인트
- Hindsight는 단순한 대화 기록 저장소가 아니라 장기 기억을 학습하는 standalone agent memory framework이다. Python 서버와 Python·Node.js·Go SDK, REST API, CLI, MCP endpoint를 함께 제공해 여러 Agent 생태계에 연결할 수 있다. LangGraph, LangChain, LlamaIndex, CrewAI, OpenAI Agents SDK, n8n 등 60개 이상의 통합 대상이 명시돼 있다.
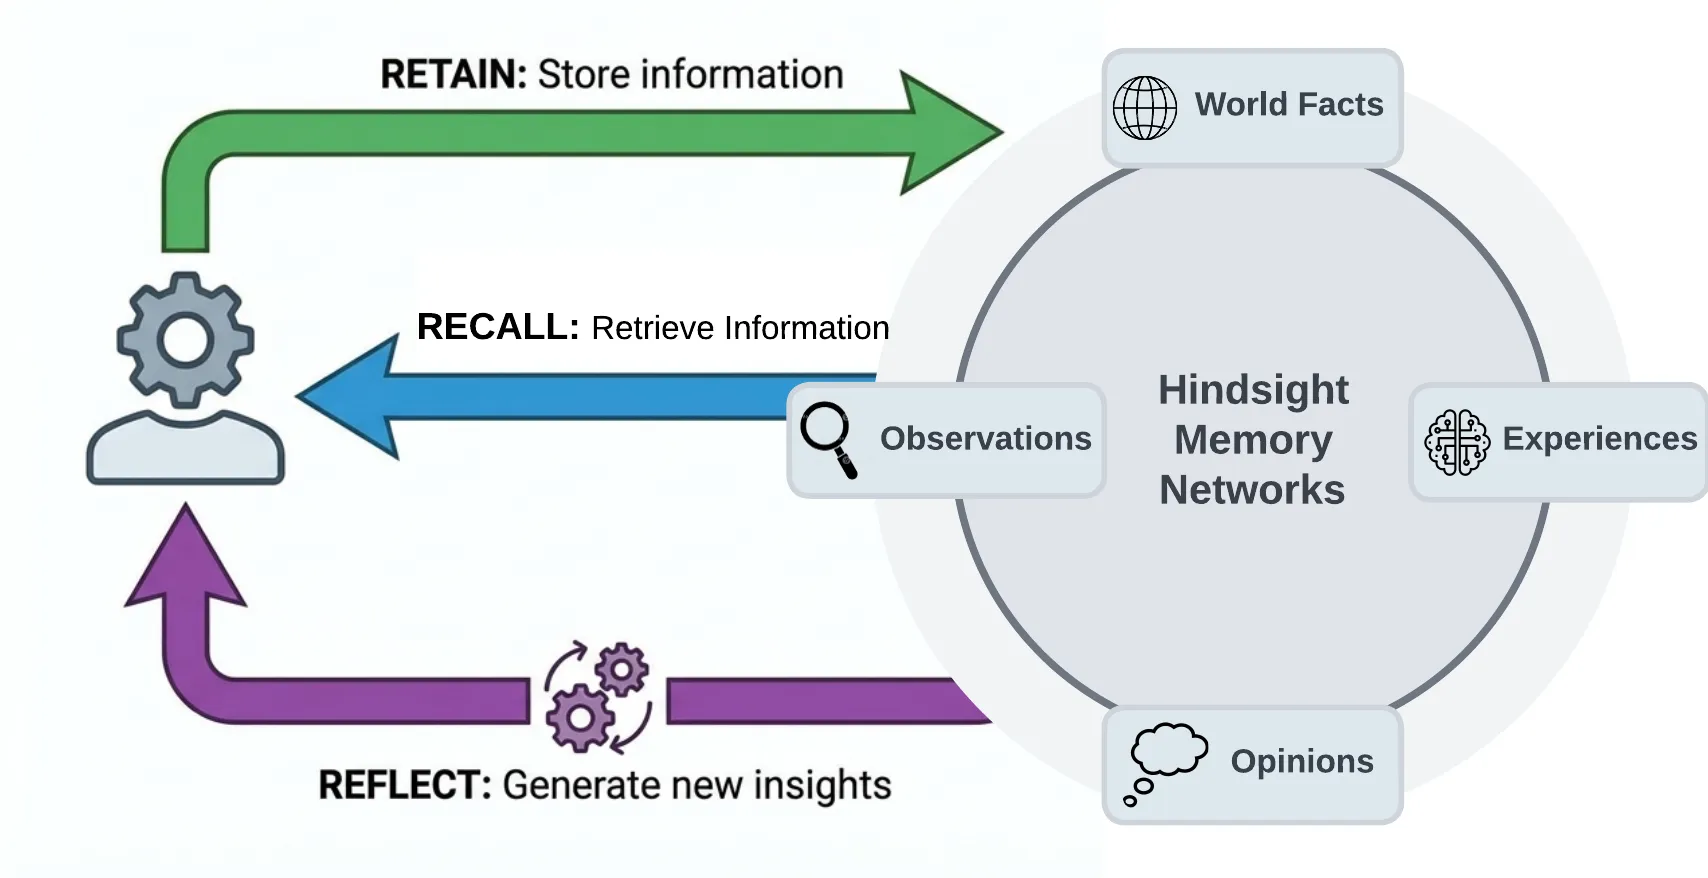
- retain은 입력을 LLM으로 처리해 핵심 사실, 시간 정보, Entity, 관계를 추출하고 정규화된 Memory Unit과 검색 인덱스로 저장한다. recall은 Semantic Search, BM25 Keyword Search, Entity·Temporal·Causal Graph Traversal, Time Series 검색을 병렬 실행한 뒤 RRF와 Cross-Encoder Reranking으로 결과를 합치고 Token Limit에 맞게 줄인다. reflect는 축적된 기억 사이의 연결을 다시 계산해 단순 조회보다 깊은 판단과 응답에 사용한다.
- 기억은 World Facts, Experiences, Observations, Mental Models로 나뉘며 Bank 단위로 격리된다. Observation은 관련 사실을 통합하면서 근거 인용과 proof count를 유지하고, 새 증거에 따라 기존 믿음을 보강하거나 약화하거나 확장한다. Mental Model과 Knowledge Page는 백그라운드에서 갱신된 답변을 저장하므로 매 세션마다 같은 정보를 다시 검색하거나 LLM으로 재구성할 필요를 줄인다.
- Docker, pip, Kubernetes Helm, Embedded DB 방식으로 배포할 수 있고 PostgreSQL·pgvector와 Oracle AI Database 23ai를 지원한다. Prometheus 지표, Webhook, 관리자 CLI, Tenant·Auth·Storage 확장 지점이 있어 운영 환경을 고려한 구성이 가능하다. 반면 단순한 n8n 워크플로에는 과할 수 있으며, LLM 호출과 메모리 저장을 별도로 운영해야 하므로 가벼운 Vector DB 대체재를 찾는 경우에는 복잡도가 높다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
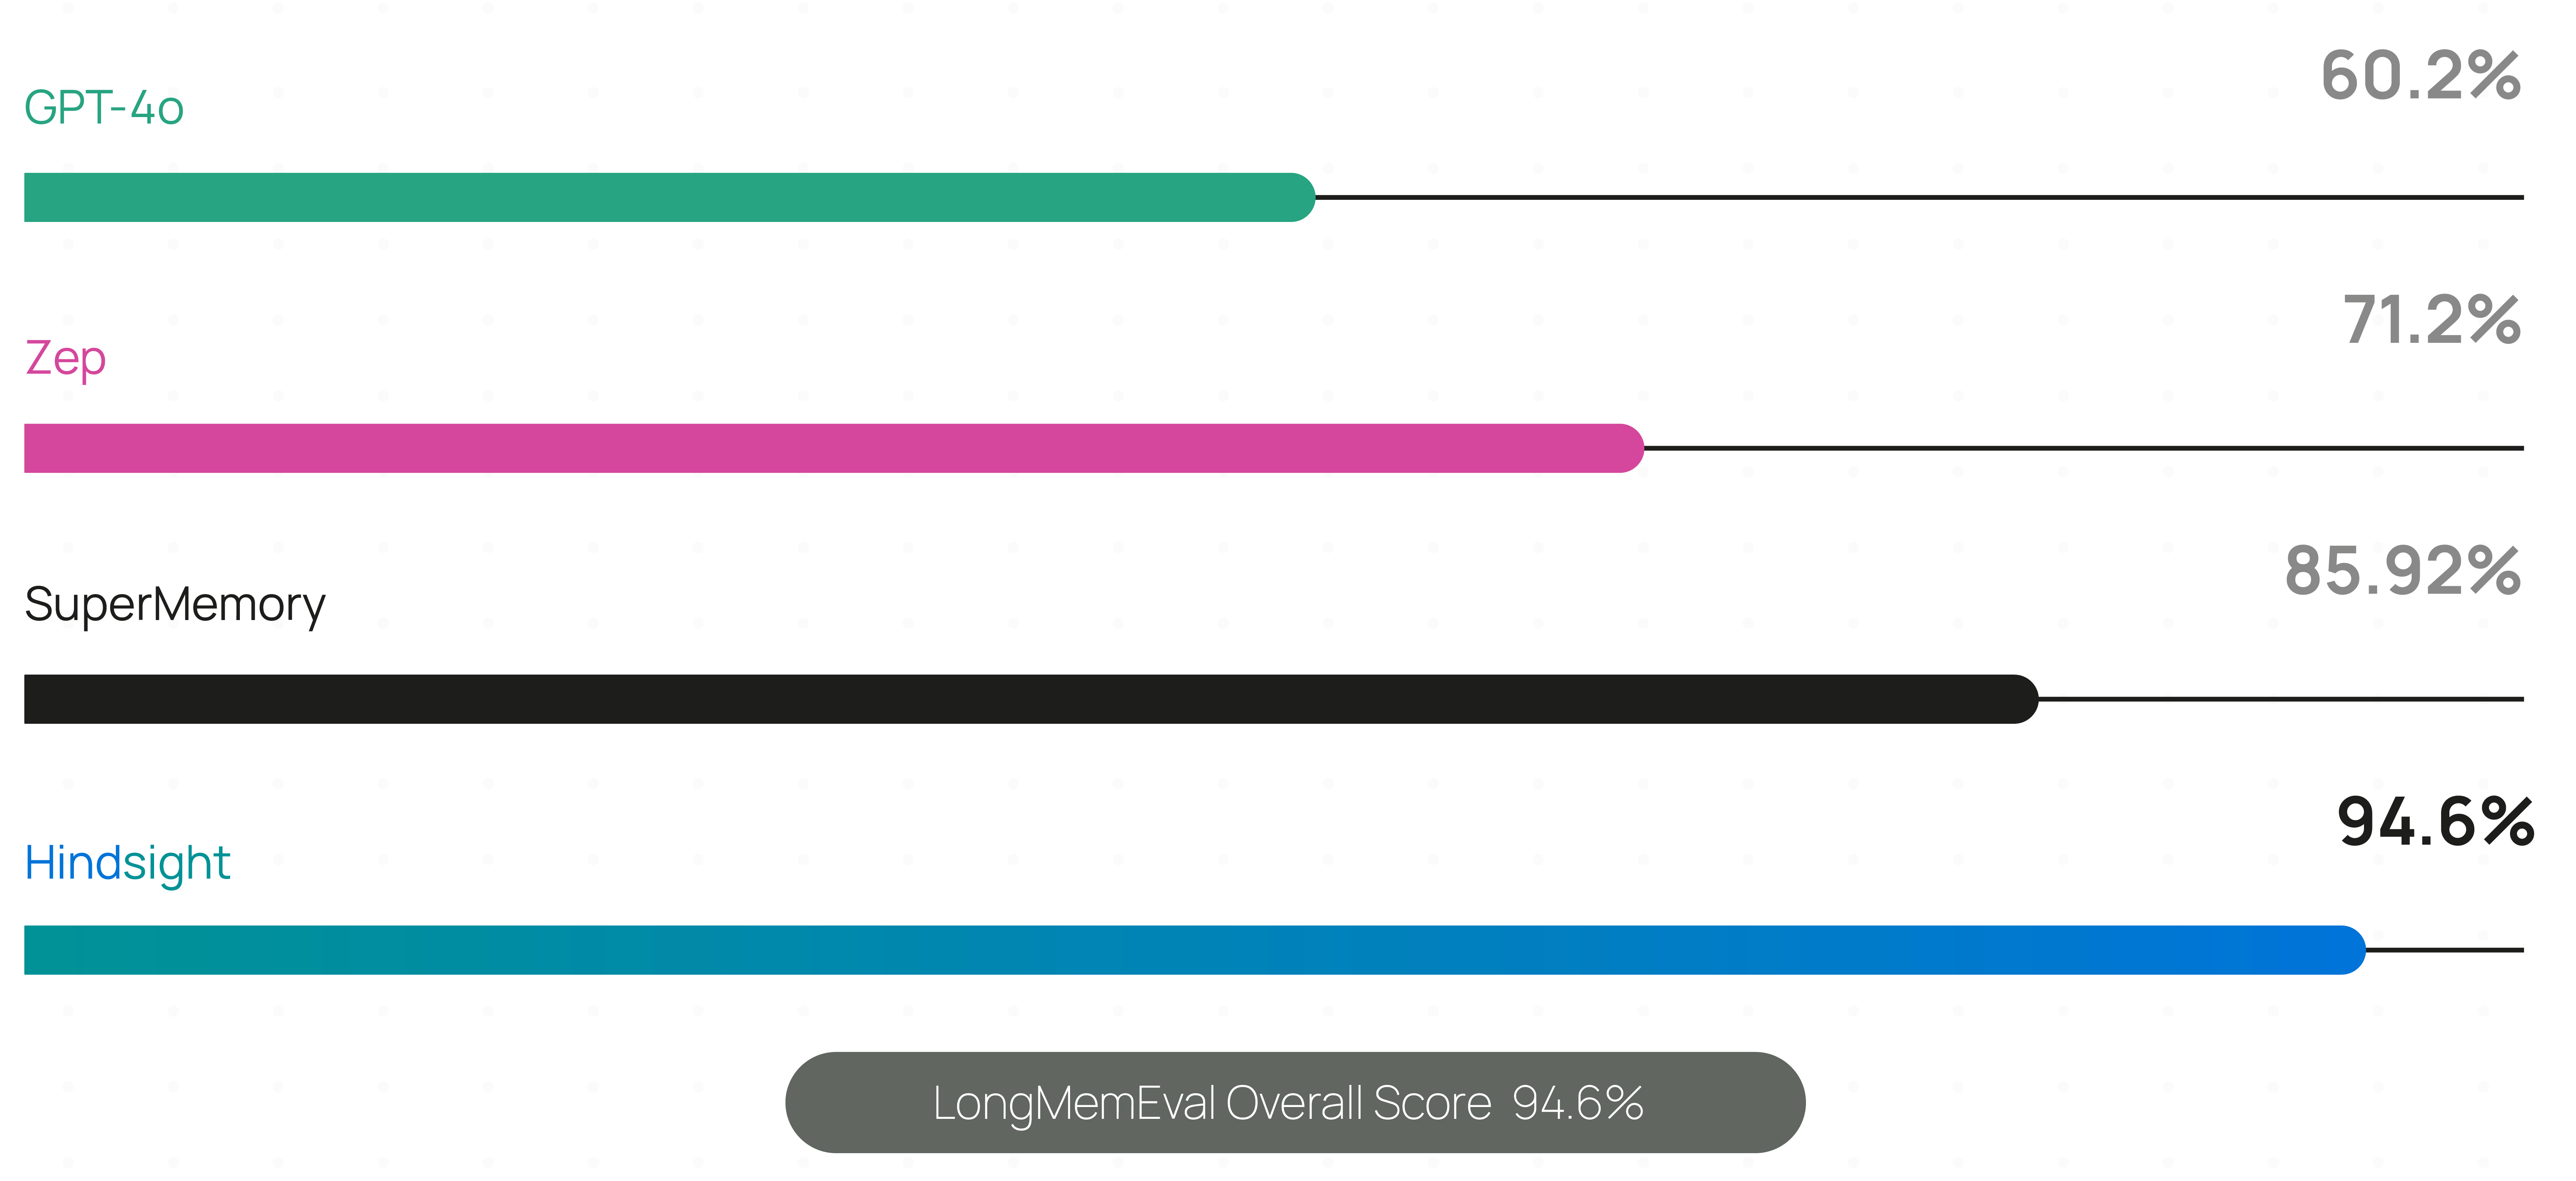
| LongMemEval | Overall Score | 94.6% | 제공된 benchmark 이미지 기준 Hindsight 점수이며, GPT-4o 60.2%, Zep 71.2%, SuperMemory 85.92%와 비교된다. README는 Virginia Tech Sanghani Center와 The Washington Post 연구 협력자들이 Hindsight 벤치마크를 독립 재현했다고 밝히지만, 다른 점수는 소프트웨어 업체의 자체 보고일 수 있다고 명시한다. |
이미지 분석


22k
STARS
1.7k
FORKS
+209
TRENDING
4
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

