DavidAU/Qwen3.6-40B-Claude-4.6-Opus-Deckard-Heretic-Uncensored-Thinking-NEO-CODE-Di-IMatrix-MAX-GGUF
27B 기반을 40B로 밀집 확장하고 Deckard·Claude 4.6 Opus 데이터와 NEO-CODE-Di-IMatrix 퀀트를 적용해 긴 컨텍스트와 이미지-텍스트 생성에서 실용성과 성능을 높인 멀티모달 모델이다.
학습 방식 · 기반 모델은 Qwen3.6-27B이며 로컬 Unsloth 파이프라인으로 Deckard (PDK 5 datasets) 기반의 캐릭터·서사 데이터와 Claude 4.6 Opus Distill 고추론 데이터로 다단계(post-training / fine-tune) 튜닝을 수행해 성능과 추론 길이를 개선했다.
TL;DR
이 모델은 Qwen3.6-27B를 기반으로 밀집 구조를 40B로 확장하고 Deckard(PkDick 등) 내러티브 데이터와 Claude 4.6 Opus Distill 데이터를 순차 튜닝해 이미지-텍스트 생성과 장문 추론 능력을 높인 멀티모달 모델이다. 핵심 기술로는 NEO-CODE-Di-IMatrix-MAX라는 맞춤 퀀트 파이프라인과 텐서별 보정을 통해 저비트 환경에서도 BF16 대비 높은 성능 재현을 노린 점이 있으며 README에서 IQ4_XS=94%·Q8_0≈98.4% 같은 퀀트 성능 비율이 보고되었다. 모델은 256K 규모의 긴 컨텍스트를 지원하고 에이전트형 코딩·멀티모달 VQA·창작 작업에서 균형 잡힌 점수를 기록했으며, Uncensored(Heretic) 모드로 필터링을 제거한 특성 때문에 안전성·운영 정책과 관련된 사용 제한을 사전에 고려해야 한다.
핵심 포인트
- 밀집 방식으로 기준 모델(27B)에서 40B로 확장한 후 다단계 튜닝을 적용한 점이 차별화 요소이다. 이 확장은 단순 파라미터 증가뿐 아니라 레이어·텐서 구조를 변경해 긴 사고 공간을 확보하는 데 목적을 두었으며 README에 96 레이어, 1,275 텐서라는 수치가 명시되어 있다. 따라서 동일 계열의 단순 파인튜닝 모델들과 구조적 용량에서 구별된다.
- NEO-CODE-Di-IMatrix-MAX라는 자체 퀀트 설계와 텐서별 보정 과정을 통해 저비트 퀀트 환경에서도 BF16에 가까운 성능 재현을 목표로 했다는 점이 고유하다. README에서 IQ4_XS·Q8_0 등 퀀트별 성능 비율을 제시하며 각 퀀트를 벤치마크 기준으로 선택했다고 밝히고 있어 퀀트 품질 관리 측면에서 차이가 있다.
- Heretic/Uncensored 모드로 먼저 자유로운 생성 성향을 구성한 뒤 Deckard·Claude 데이터로 안정성과 추론 능력을 보정하는 순차적 튜닝 파이프라인이 적용되었다. 이 구성은 모델이 창작적·공격적 표현을 허용하면서도 이후 단계에서 문제 해결·추론 안정성을 복원하도록 설계되었다는 점에서 운영·사용 관점의 차별화를 만든다.
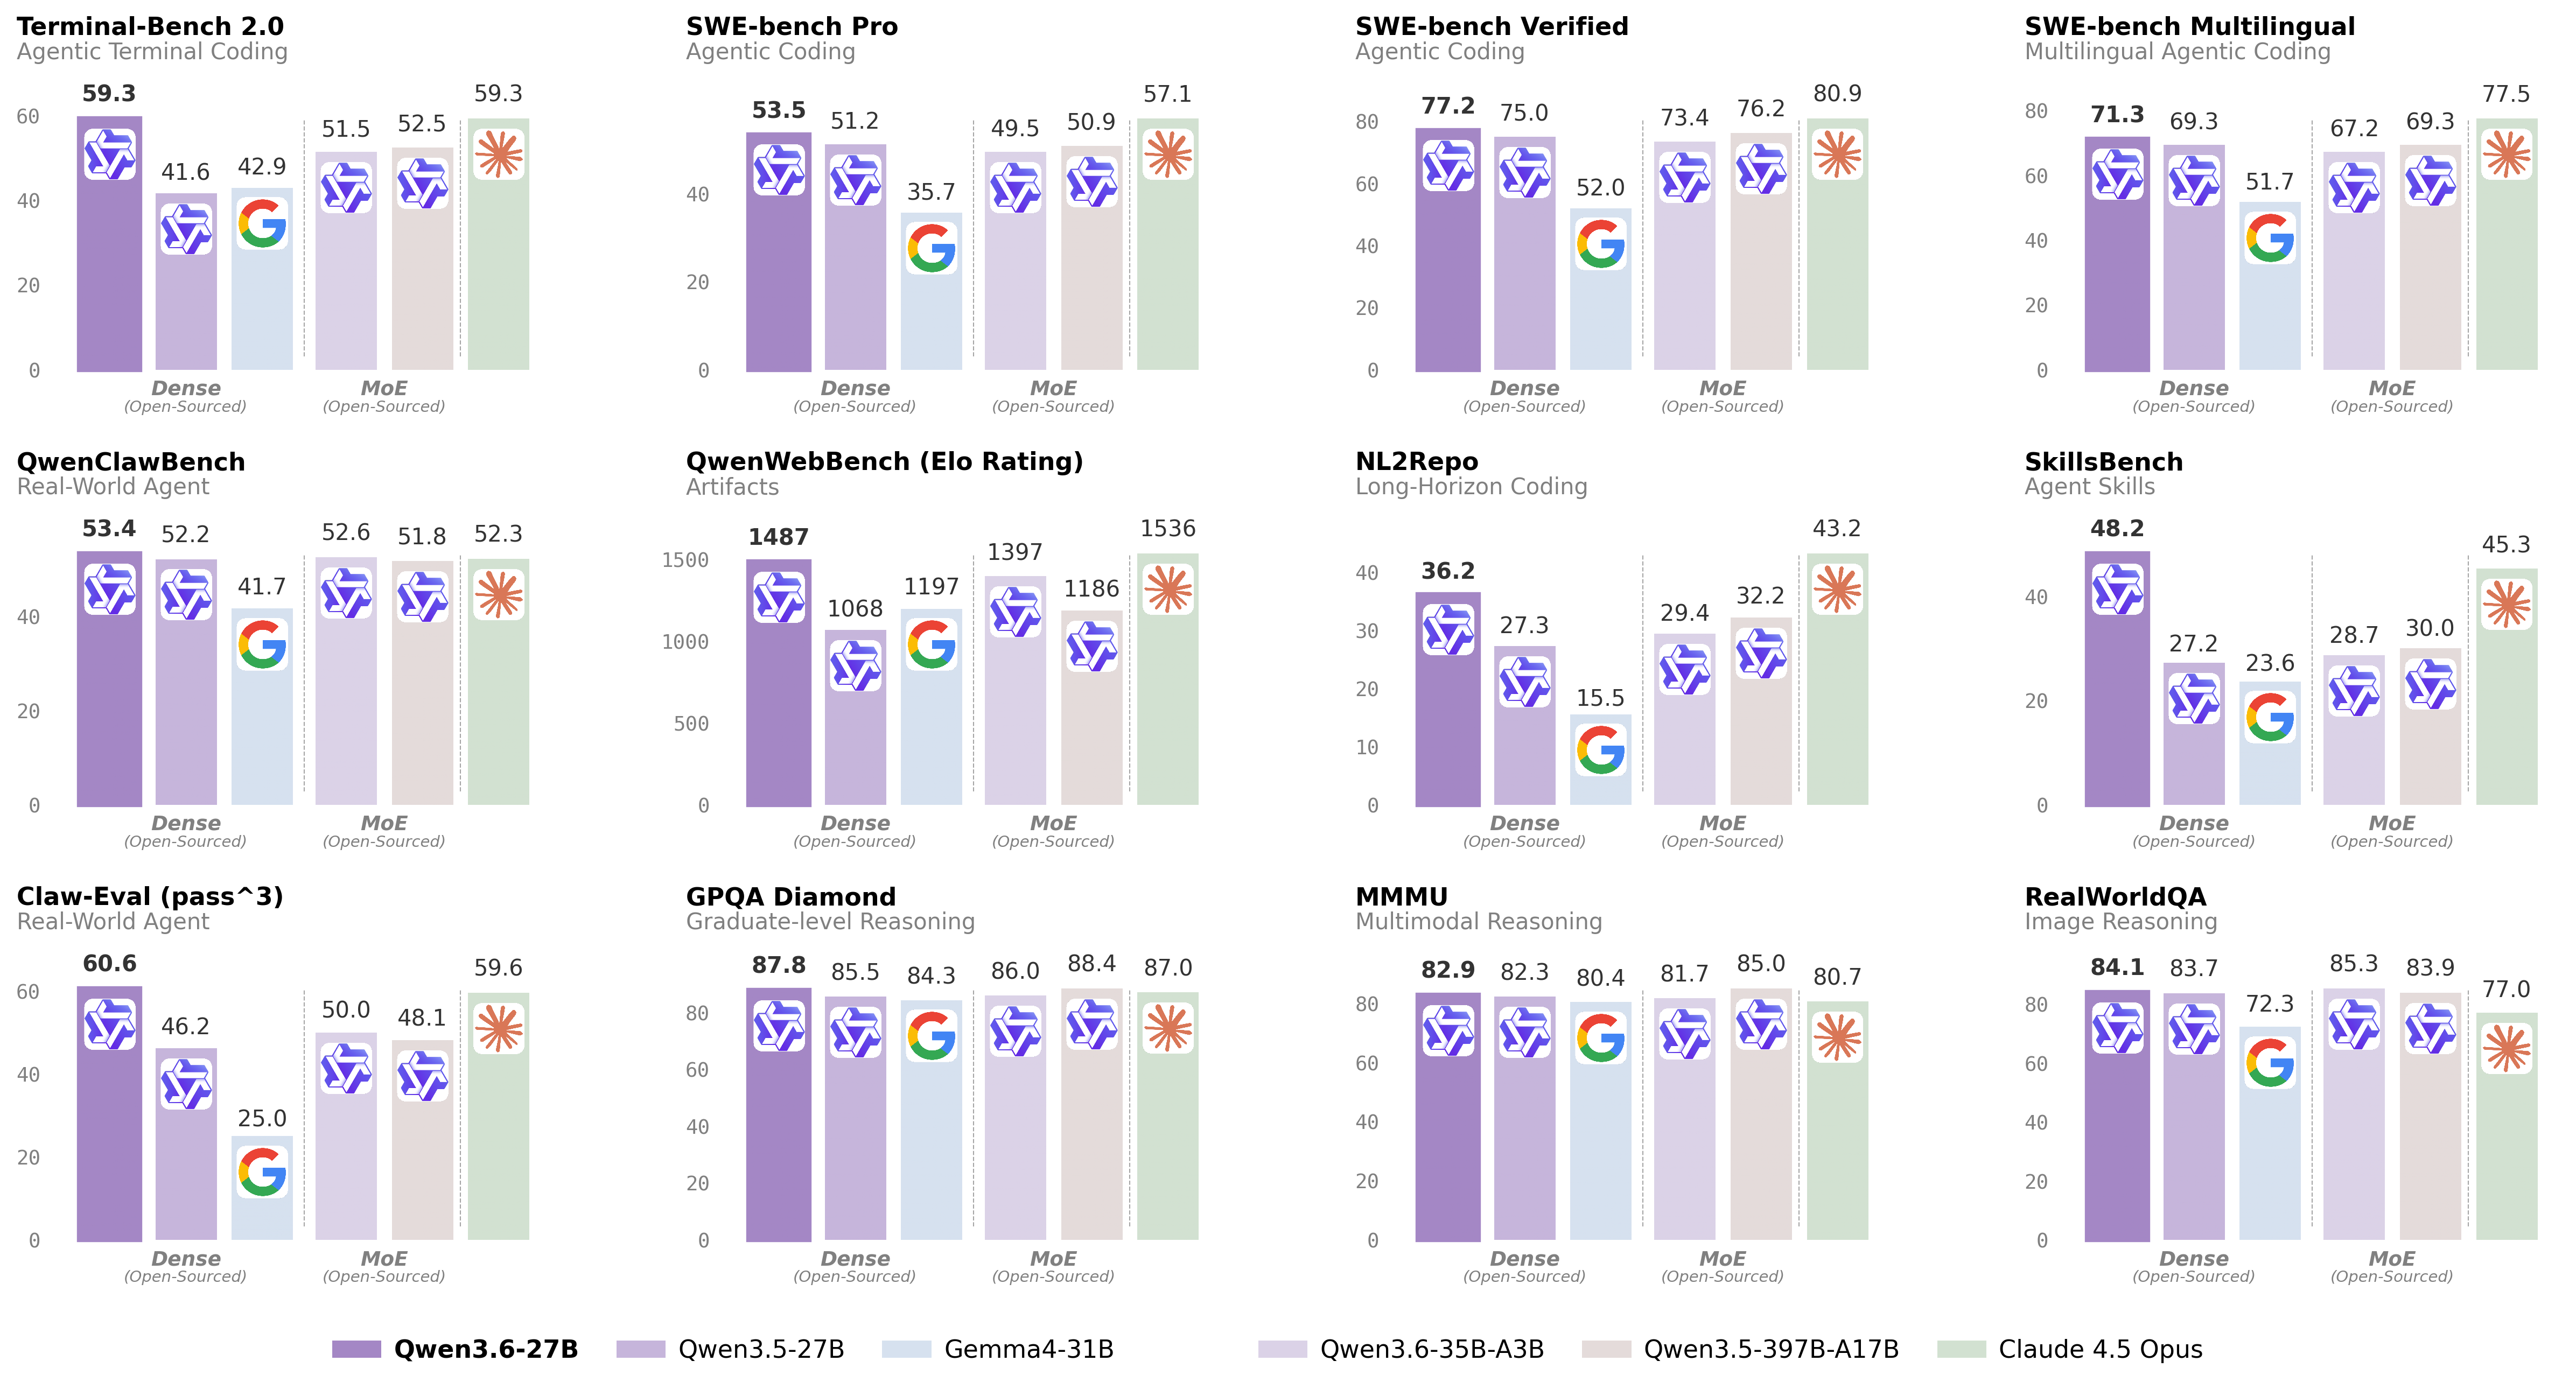
- 다중 벤치마크 표에서 전반적으로 경쟁력 있는 점수가 보고되었다는 사실이 README 표에서 확인된다. 특히 QwenWebBench Elo 1487, MMLU-Pro 86.2, LiveCodeBench·Claw 관련 지표에서 높은 실수를 보이며 코드·지식·멀티모달 태스크에서 균형 잡힌 성능을 보여준다. 이러한 수치들은 모델이 에이전트형 코딩 및 장문 추론 시 실용적 성능을 발휘함을 시사한다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
| SWE-bench Verified | score | 77.2 | vs Claude 4.5 Opus: 80.9 |
| Terminal-Bench 2.0 | score | 59.3 | vs Claude 4.5 Opus: 59.3 |
| QwenWebBench (Elo) | elo | 1487 | vs Claude 4.5 Opus: 1536 |
| Claw-Eval (pass^3) | pass@3 | 60.6 | vs Claude 4.5 Opus: 59.6 |
| MMLU-Pro | accuracy | 86.2 | vs Claude 4.5 Opus: 89.5 |
| RealWorldQA | accuracy | 84.1 | vs Claude 4.5 Opus: 77.0 |
이미지 분석
572
LIKES
427.1k
DOWNLOADS
1 / 0
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

