unsloth/Qwen3.6-27B-MTP-GGUF
Qwen3.6-27B의 GGUF 양자화 빌드로 MTP와 preserve_thinking을 결합해 멀티모달 에이전트 작업과 초장문 컨텍스트 처리를 최적화한 배포판이다.
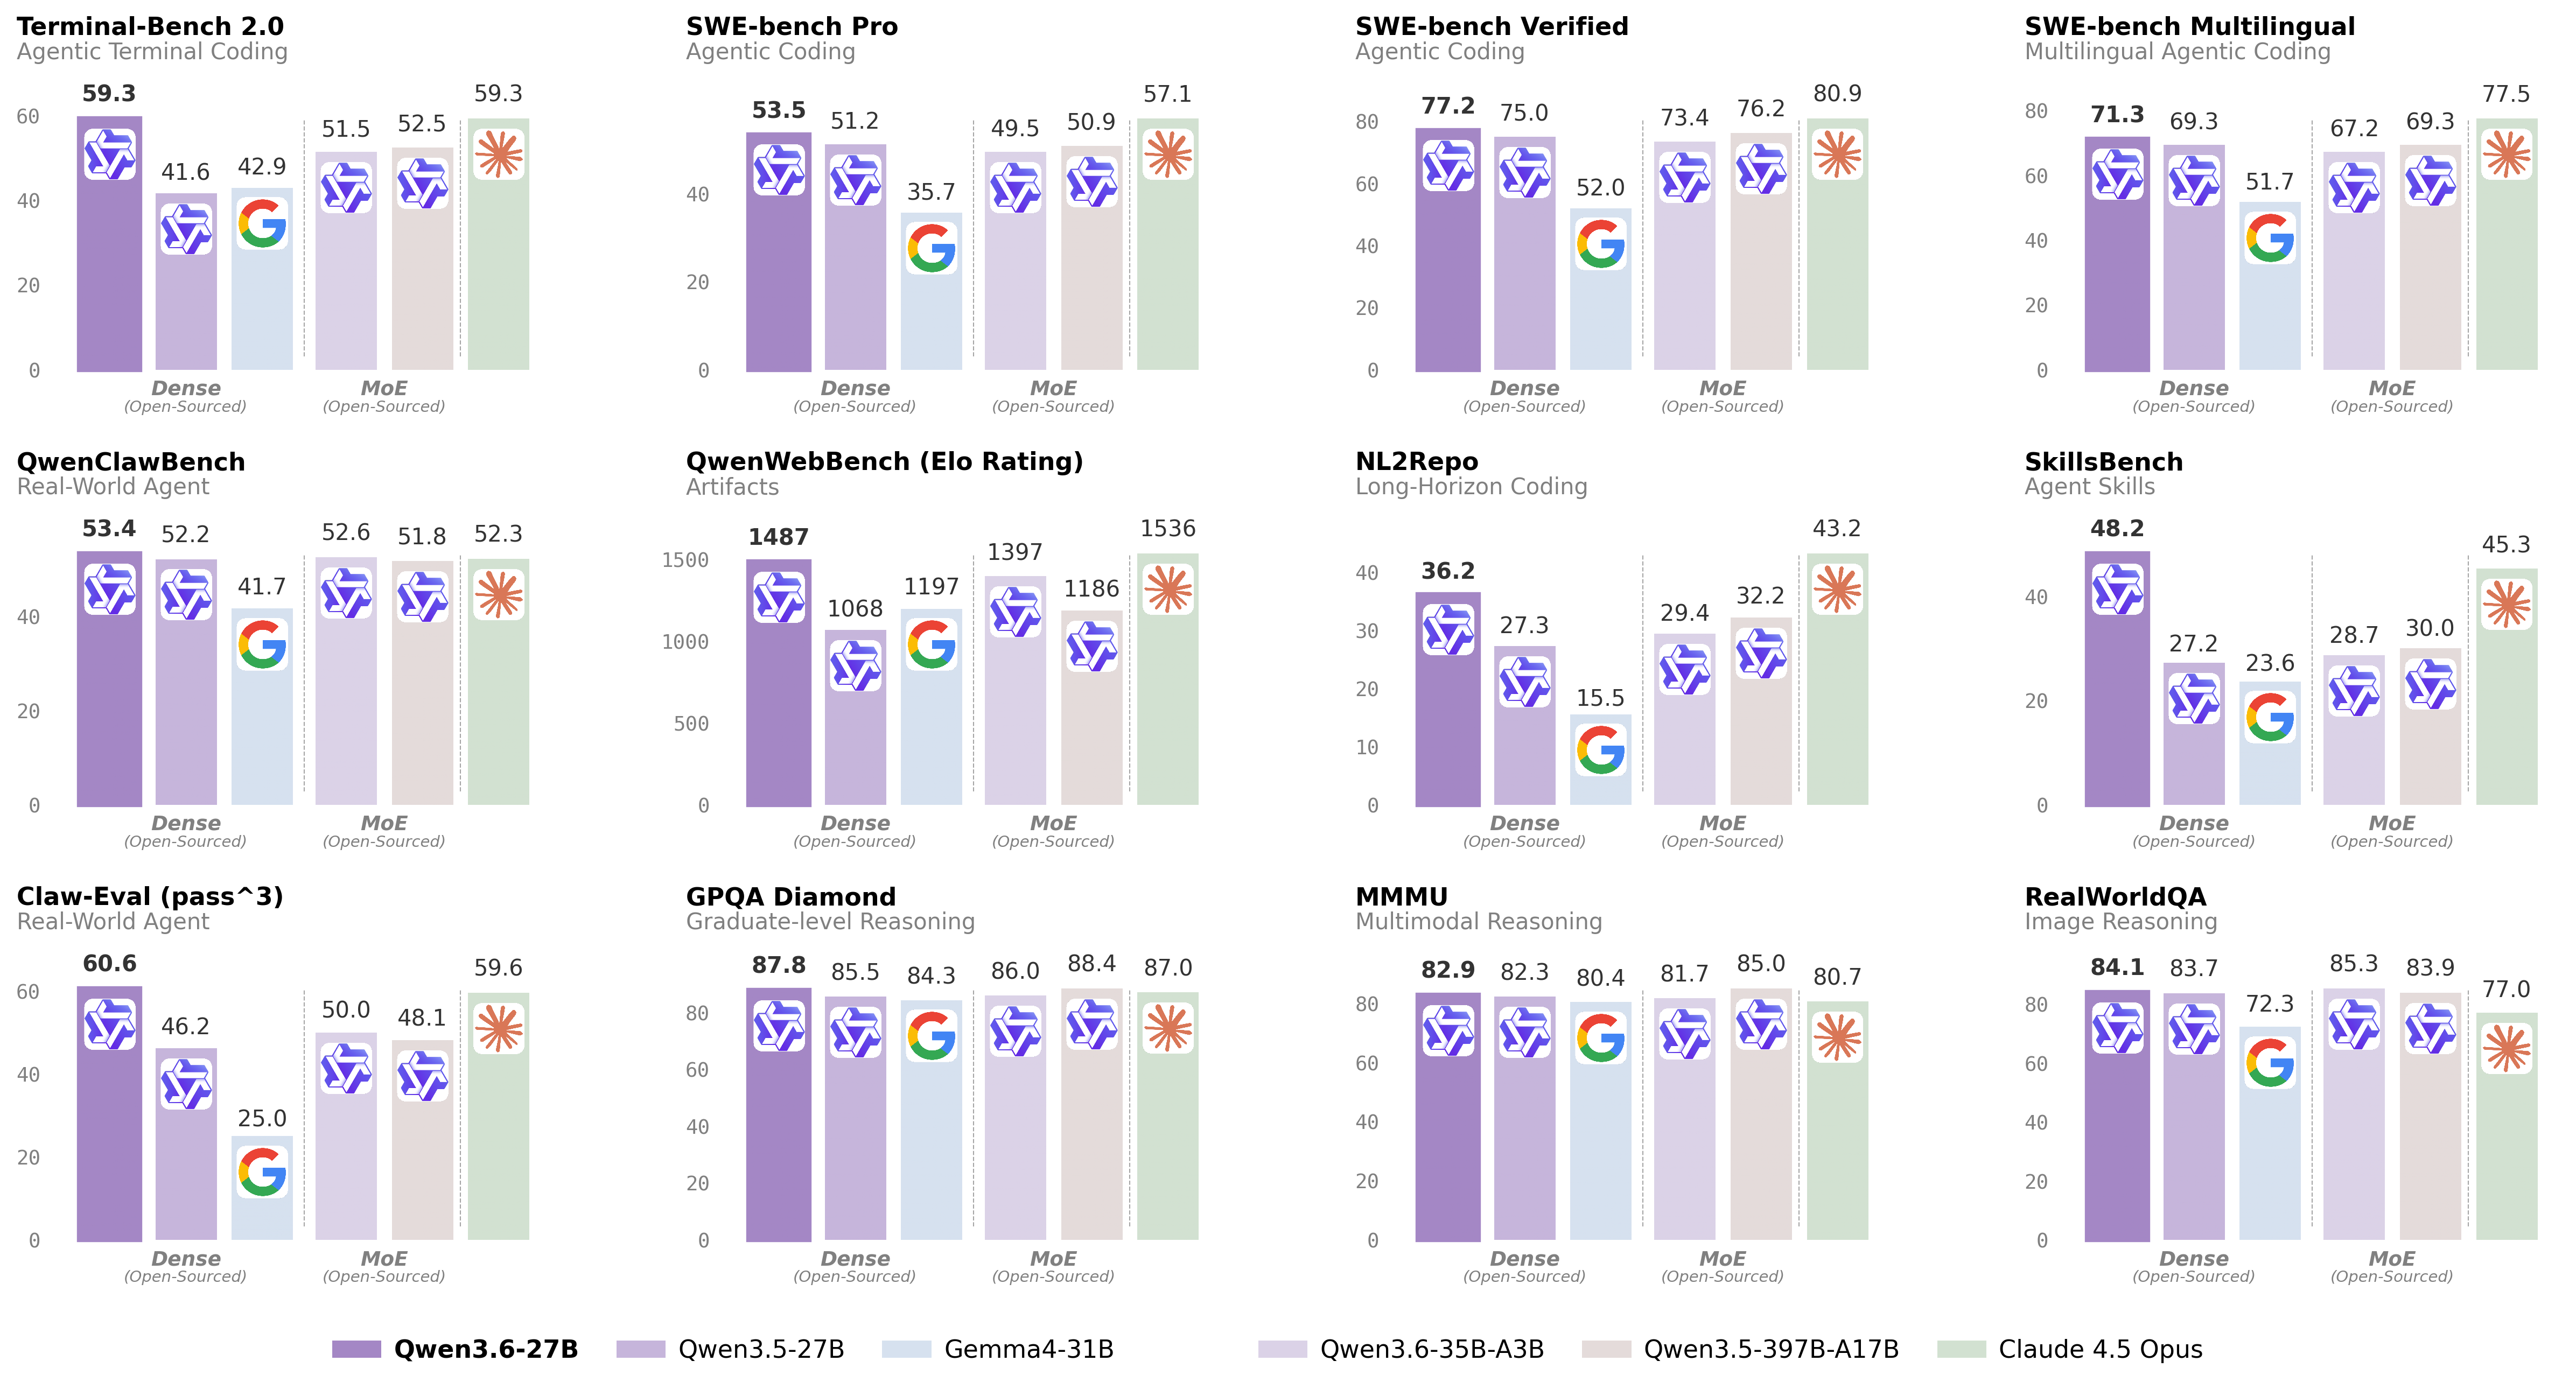
학습 방식 · Qwen3.6은 대규모 사전학습 후 포스트트레이닝으로 안정성·실무성 개선을 목표로 추가 튜닝되었으며, MTP와 Thinking 보존용 추가 트레이닝을 거쳐 에이전트형 워크로드에서 연속적 사고를 활용하도록 조정되었다.
TL;DR
Qwen3.6-27B의 Unsloth 배포판은 GGUF 양자화 산출물과 MTP(Multi-Token Prediction) 추론 경로를 결합해 로컬 및 서버 환경에서 멀티모달 에이전트와 코딩 워크플로를 효율적으로 지원한다. 모델은 vision encoder를 포함한 27B 규모의 causal 구조, Gated DeltaNet과 Gated Attention 블록, 네이티브 262,144 토큰 컨텍스트를 갖추었고 YaRN 설정을 통해 최대 1,010,000 토큰까지 확장할 수 있다. README와 이미지에서는 MTP로 추론 속도를 약 1.5~2배 개선한다고 명시하고 있으며 Unsloth Studio와의 통합으로 하드웨어별 최적 MTP 설정을 자동화할 수 있다. 권장 서빙 엔진(vLLM, SGLang 등)과 구체적 시작 명령을 제공하므로 프로덕션 배포 시 프레임워크 호환성·메모리 설정·YaRN의 정적 스케일링이 초래할 수 있는 짧은 텍스트 성능 영향을 고려해야 한다.
핵심 포인트
- Unsloth가 제공하는 GGUF 양자화 배포는 로컬 경량 런타임에서 즉시 실행 가능한 아티팩트를 제공하며, llama.cpp와의 명확한 통합 예시를 포함해 개발자가 환경별로 빠르게 배포할 수 있도록 돕는다. 이 배포판은 특히 다운로드와 로컬 실험에 최적화되어 있어 엔지니어가 프로토타이핑을 신속히 수행할 수 있다.
- 추론 수준에서 MTP와 Thinking Mode, preserve_thinking 옵션을 동시에 제공해 에이전트형 워크플로에서 사고흔적 유지와 처리량 개선을 병행할 수 있도록 설계된 점이 특징이다. 이러한 조합은 도구 호출과 반복적 코드 개선 같은 시나리오에서 토큰 효율과 일관성을 동시에 개선한다.
- 대규모 네이티브 컨텍스트(262K 토큰)와 YaRN을 통한 확장성, 그리고 vLLM·SGLang·KTransformers 같은 여러 서빙 엔진에 대한 구체적 가이드와 명령어를 README에 포함해 장기적·고성능 배포를 고려한 실무 문서화를 제공한다. 프레임워크별 오버라이드 예시를 통해 실제 운영 환경에서의 적용 장벽을 낮춘 점이 실무적 차별점이다.
- GGUF 양자화 빌드로 로컬 및 경량 런타임에서 높은 접근성을 제공하며 다운로드 수와 사용 사례가 풍부해 실무 적용이 용이하다. 이로 인해 개발자들이 로컬에서 빠르게 실험하고 배포할 수 있는 환경을 확보하게 된다. Apache-2.0 라이선스로 상업적 이용과 재배포에 제약이 적다.
이미지 분석

1.1k
LIKES
2.9M
DOWNLOADS
0 / 0
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

