unsloth/Qwen3.6-27B-NVFP4
이미지와 텍스트를 함께 입력받아 텍스트 출력을 생성하는 image-text-to-text 멀티모달 태스크와 에이전트형 코딩 및 장문 추론을 포함한 대화형 응답 생성 작업을 수행한다. 모델은 시각 입력을 이해해 코드·문서·질문응답을 생성하거나 편집 지시를 처리하는 데 최적화되어 있다. 장문 컨텍스트를 활용한 리포지토 수준의 reasoning과 툴 호출을 포함한 에이전트 워크플로를 지원하도록 설계되었다.27B262K 컨텍스트apache-2.0
Qwen3.6-27B 기반의 Unsloth NVFP4 양자화 체크포인트로 24GB GPU에서 동작하며 NVFP4 보정과 MTP를 통해 원본 성능을 유지하면서 추론 처리량을 크게 높였다.
학습 방식 · Qwen3.6-27B를 기반으로 사전학습 후 포스트트레이닝·보정(post-training calibration)을 통해 NVFP4 양자화를 적용했으며, 보정 데이터로 Unsloth 내부 데이터와 UltraChat을 혼합해 정밀도 유지와 추론 효율을 동시에 확보했다.
TL;DR
Qwen3.6-27B NVFP4는 Qwen3.6 27B 기반의 post-trained 양자화 아티팩트로 Unsloth와 UltraChat 데이터로 보정하여 NVFP4 특유의 저비트 표현으로도 주요 벤치마크 정확도를 유지하도록 설계되었다. 이 체크포인트는 MTP 모듈을 포함해 speculative multi-token 초안 생성으로 디코딩-처리량 트레이드를 런타임에서 조정할 수 있으며, vLLM·cute-DSL·flashinfer 계열 백엔드 조합에서 최대 2.5배 수준의 처리량 향상을 보고했다. 컨텍스트 길이 262,144 토큰을 기본으로 지원하고 24GB VRAM 환경에서 동작하도록 최적화되어 있어 긴 컨텍스트와 멀티모달 에이전트 워크플로에 적용 가능하나, 최종 처리량은 백엔드와 런타임 설정에 크게 좌우된다는 제한이 있다.
핵심 포인트
- NVFP4 양자화 아티팩트를 재보정해 다른 NVFP4 구현보다 높은 처리량을 목표로 설계했다.
- MTP 모듈을 포함해 speculative multi-token 초안 생성으로 디코딩 트레이드오프를 런타임에서 조정할 수 있다.
- 24GB VRAM 환경에서 동작 가능한 양자화 설정으로 범용 GPU에서 배포 가능성을 높였다.
- 다수의 고성능 추론 백엔드(vLLM, cute-DSL, flashinfer 등)와 명시적 호환성 지침을 제공한다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
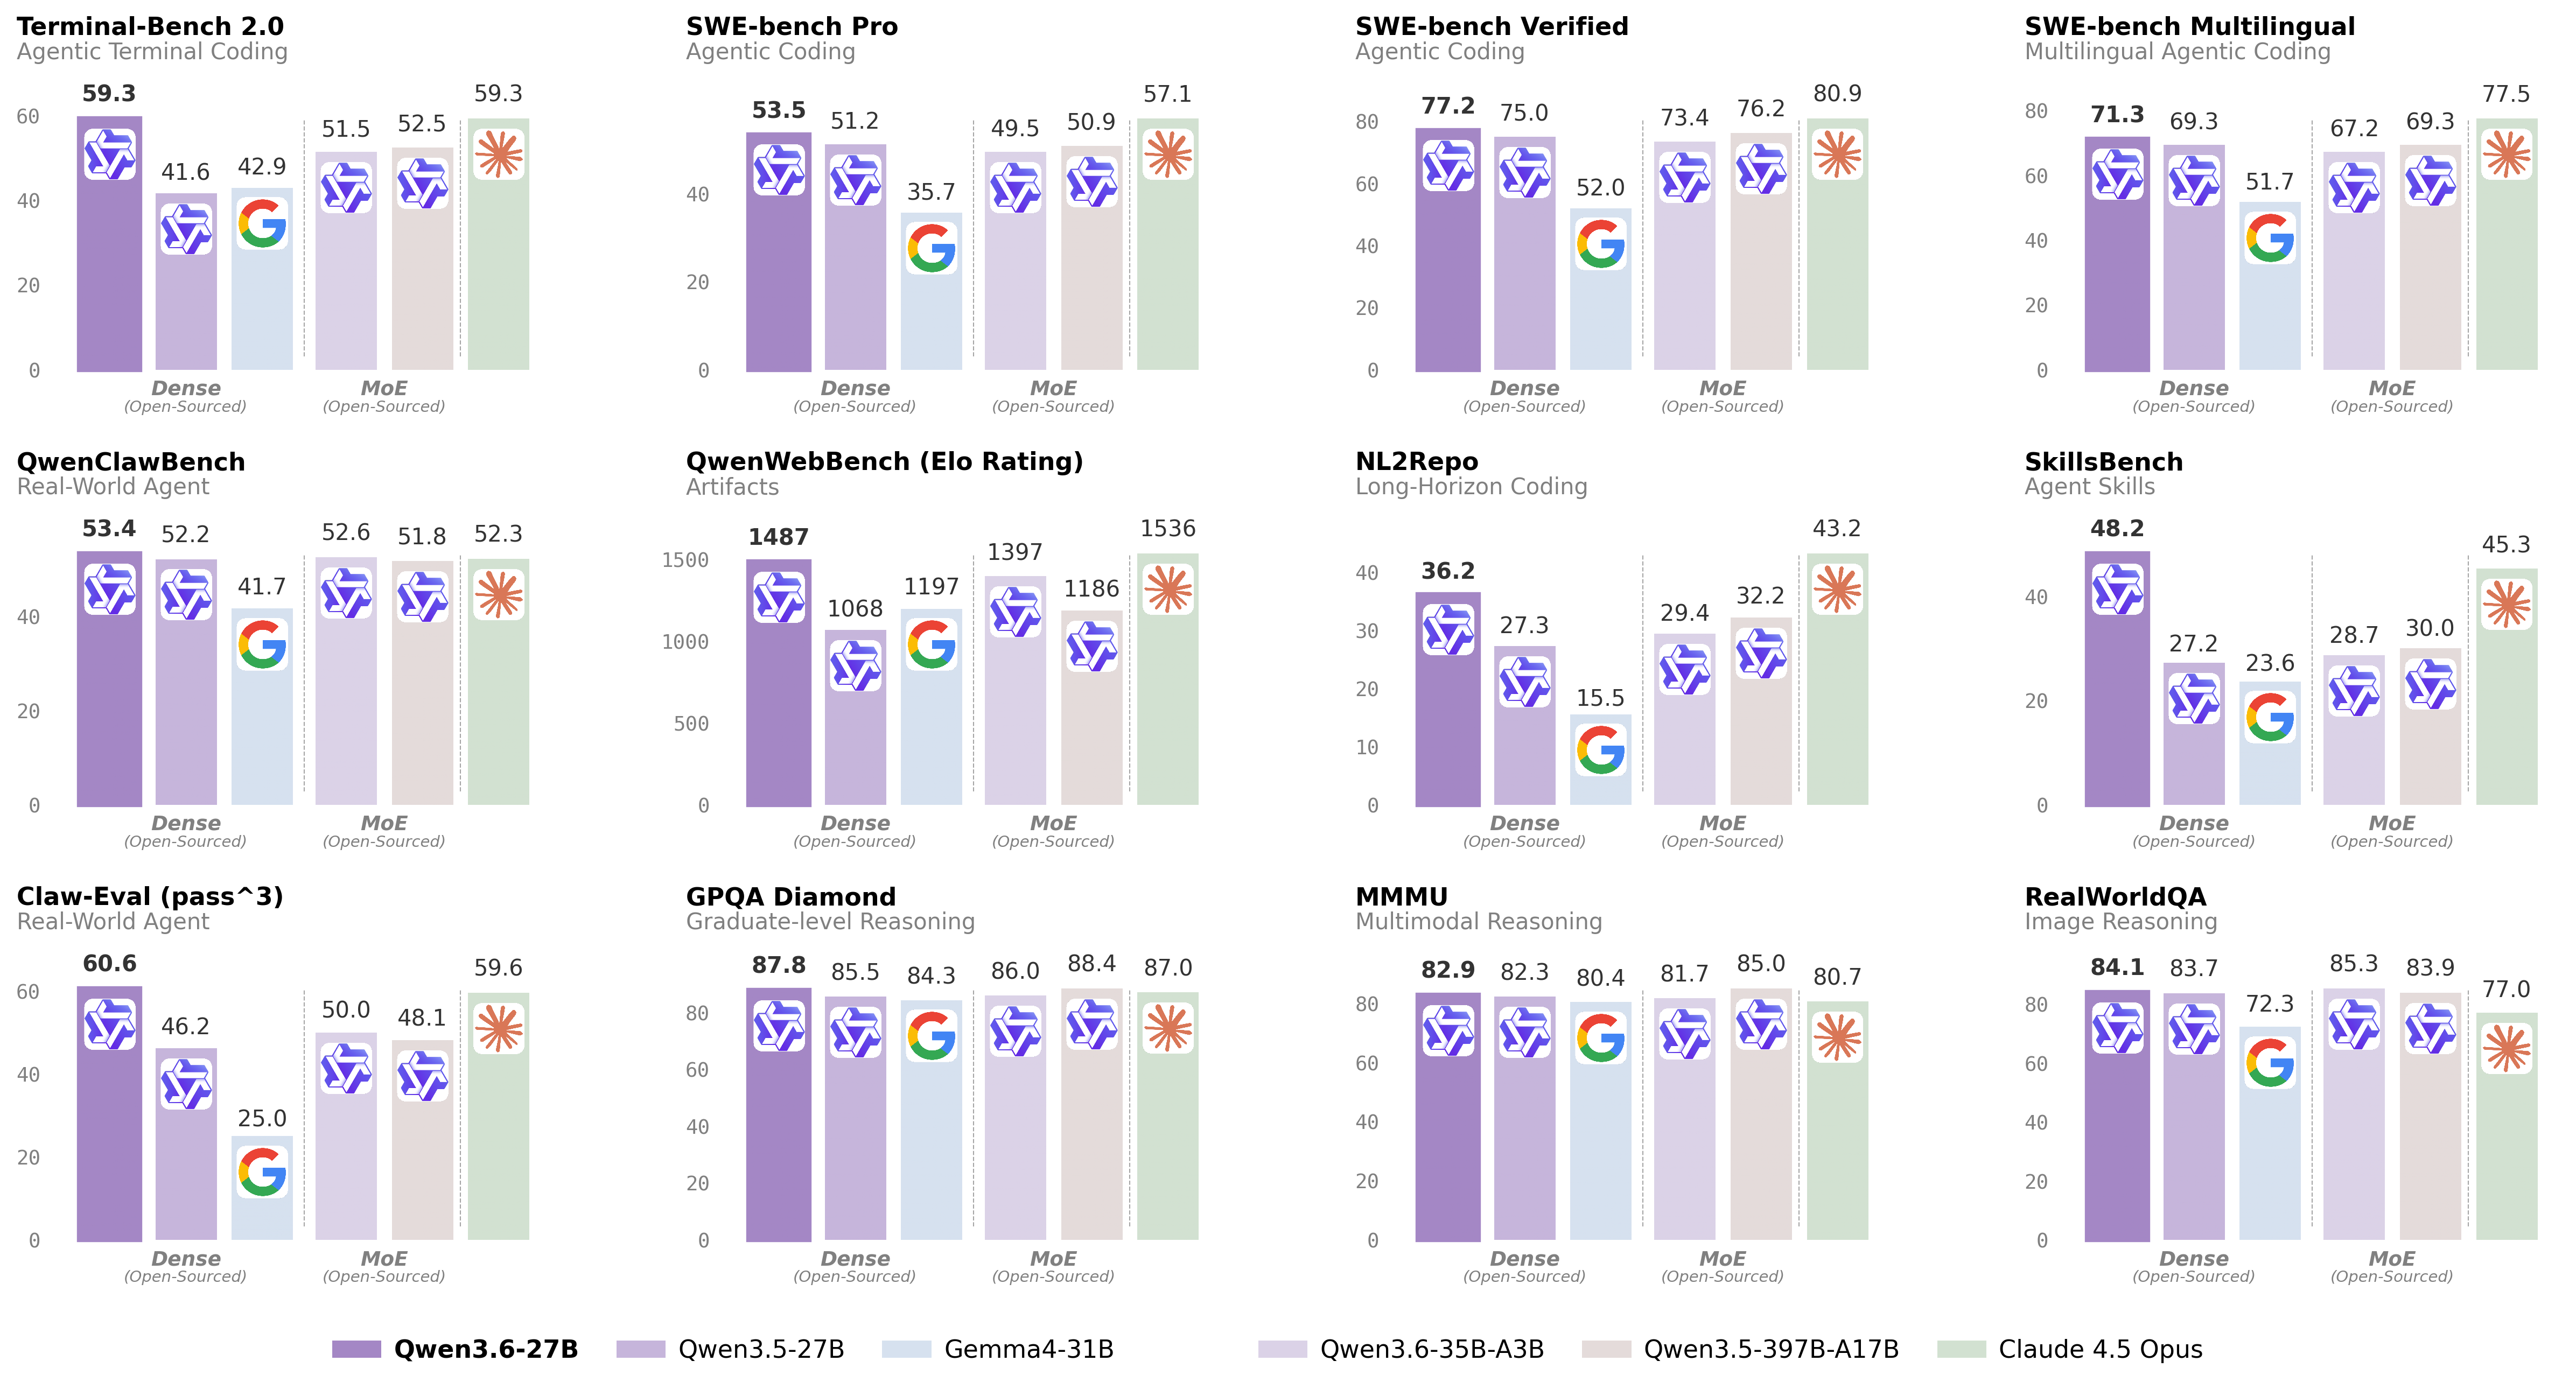
| MMLU-Pro | accuracy | 86.2 | — |
| GPQA Diamond | accuracy | 87.8 | — |
| QwenWebBench (Elo) | elo | 1487 | — |
| Terminal-Bench 2.0 | score | 59.3 | — |
| Claw-Eval (pass^3) | pass^3 | 60.6 | — |
| RealWorldQA | accuracy | 84.1 | — |
이미지 분석

233
LIKES
2.1M
DOWNLOADS
0 / 0
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

