unsloth/Qwen3.6-35B-A3B-NVFP4-Fast
Unsloth가 Qwen3.6-35B-A3B 기반으로 NVFP4 양자화와 MTP 모듈을 적용해 32GB VRAM에서 작동하도록 조정한 고효율 이미지-텍스트-투-텍스트 추론 체크포인트이다.
학습 방식 · Qwen3.6-35B-A3B 기반에서 사전학습 및 post-training을 거친 후 Unsloth 데이터셋과 UltraChat 데이터셋을 사용해 NVFP4 양자화 보정과 MTP 관련 추가 튜닝을 진행한 체크포인트이다.
TL;DR
Unsloth가 Qwen3.6-35B-A3B 기반 체크포인트를 NVFP4 양자화로 보정하고 MTP 모듈을 포함해 32GB VRAM 환경에서 동작하도록 최적화한 모델이며, README의 실험에서 동일 NVFP4 계열 대비 처리량이 최대 1.79배 향상된 것으로 보고되었다. 모델은 MoE 기반의 아키텍처와 Gated DeltaNet/Gated Attention 블록을 사용해 멀티모달 이해와 긴 컨텍스트 처리 능력을 제공하며 RealWorldQA, OmniDocBench, MMLU-Pro 등 여러 벤치에서 경쟁력 있는 정확도를 보였다. 서빙은 vLLM, SGLang, cute-DSL/trtllm 조합을 권장하며 잘못된 백엔드 선택 시 성능이 크게 저하될 수 있다는 운영상의 주의사항이 명시되어 있다. 따라서 NVFP4 보정과 런타임 최적화를 통해 비용·처리량·정확도의 균형을 맞춘 멀티모달 배포 시 명확한 장점이 있다.
핵심 포인트
- Unsloth NVFP4 Fast는 동일 NVFP4 계열 중에서도 보정된 체크포인트와 런타임 최적화를 통해 처리량을 우선으로 설계되어 35B-A3B 구성에서 README가 보고한 수치로 1.79배 높은 스루풋을 달성했다. 이 우위는 양자화 알고리즘의 보정 절차와 특정 추론 백엔드(cute-DSL, trtllm 등) 조합에서 나타난 실측 결과에 기반한다. 따라서 동일 모델 크기와 양자화 형식 하에서 높은 처리량이 필요한 배포에 차별점을 제공한다.
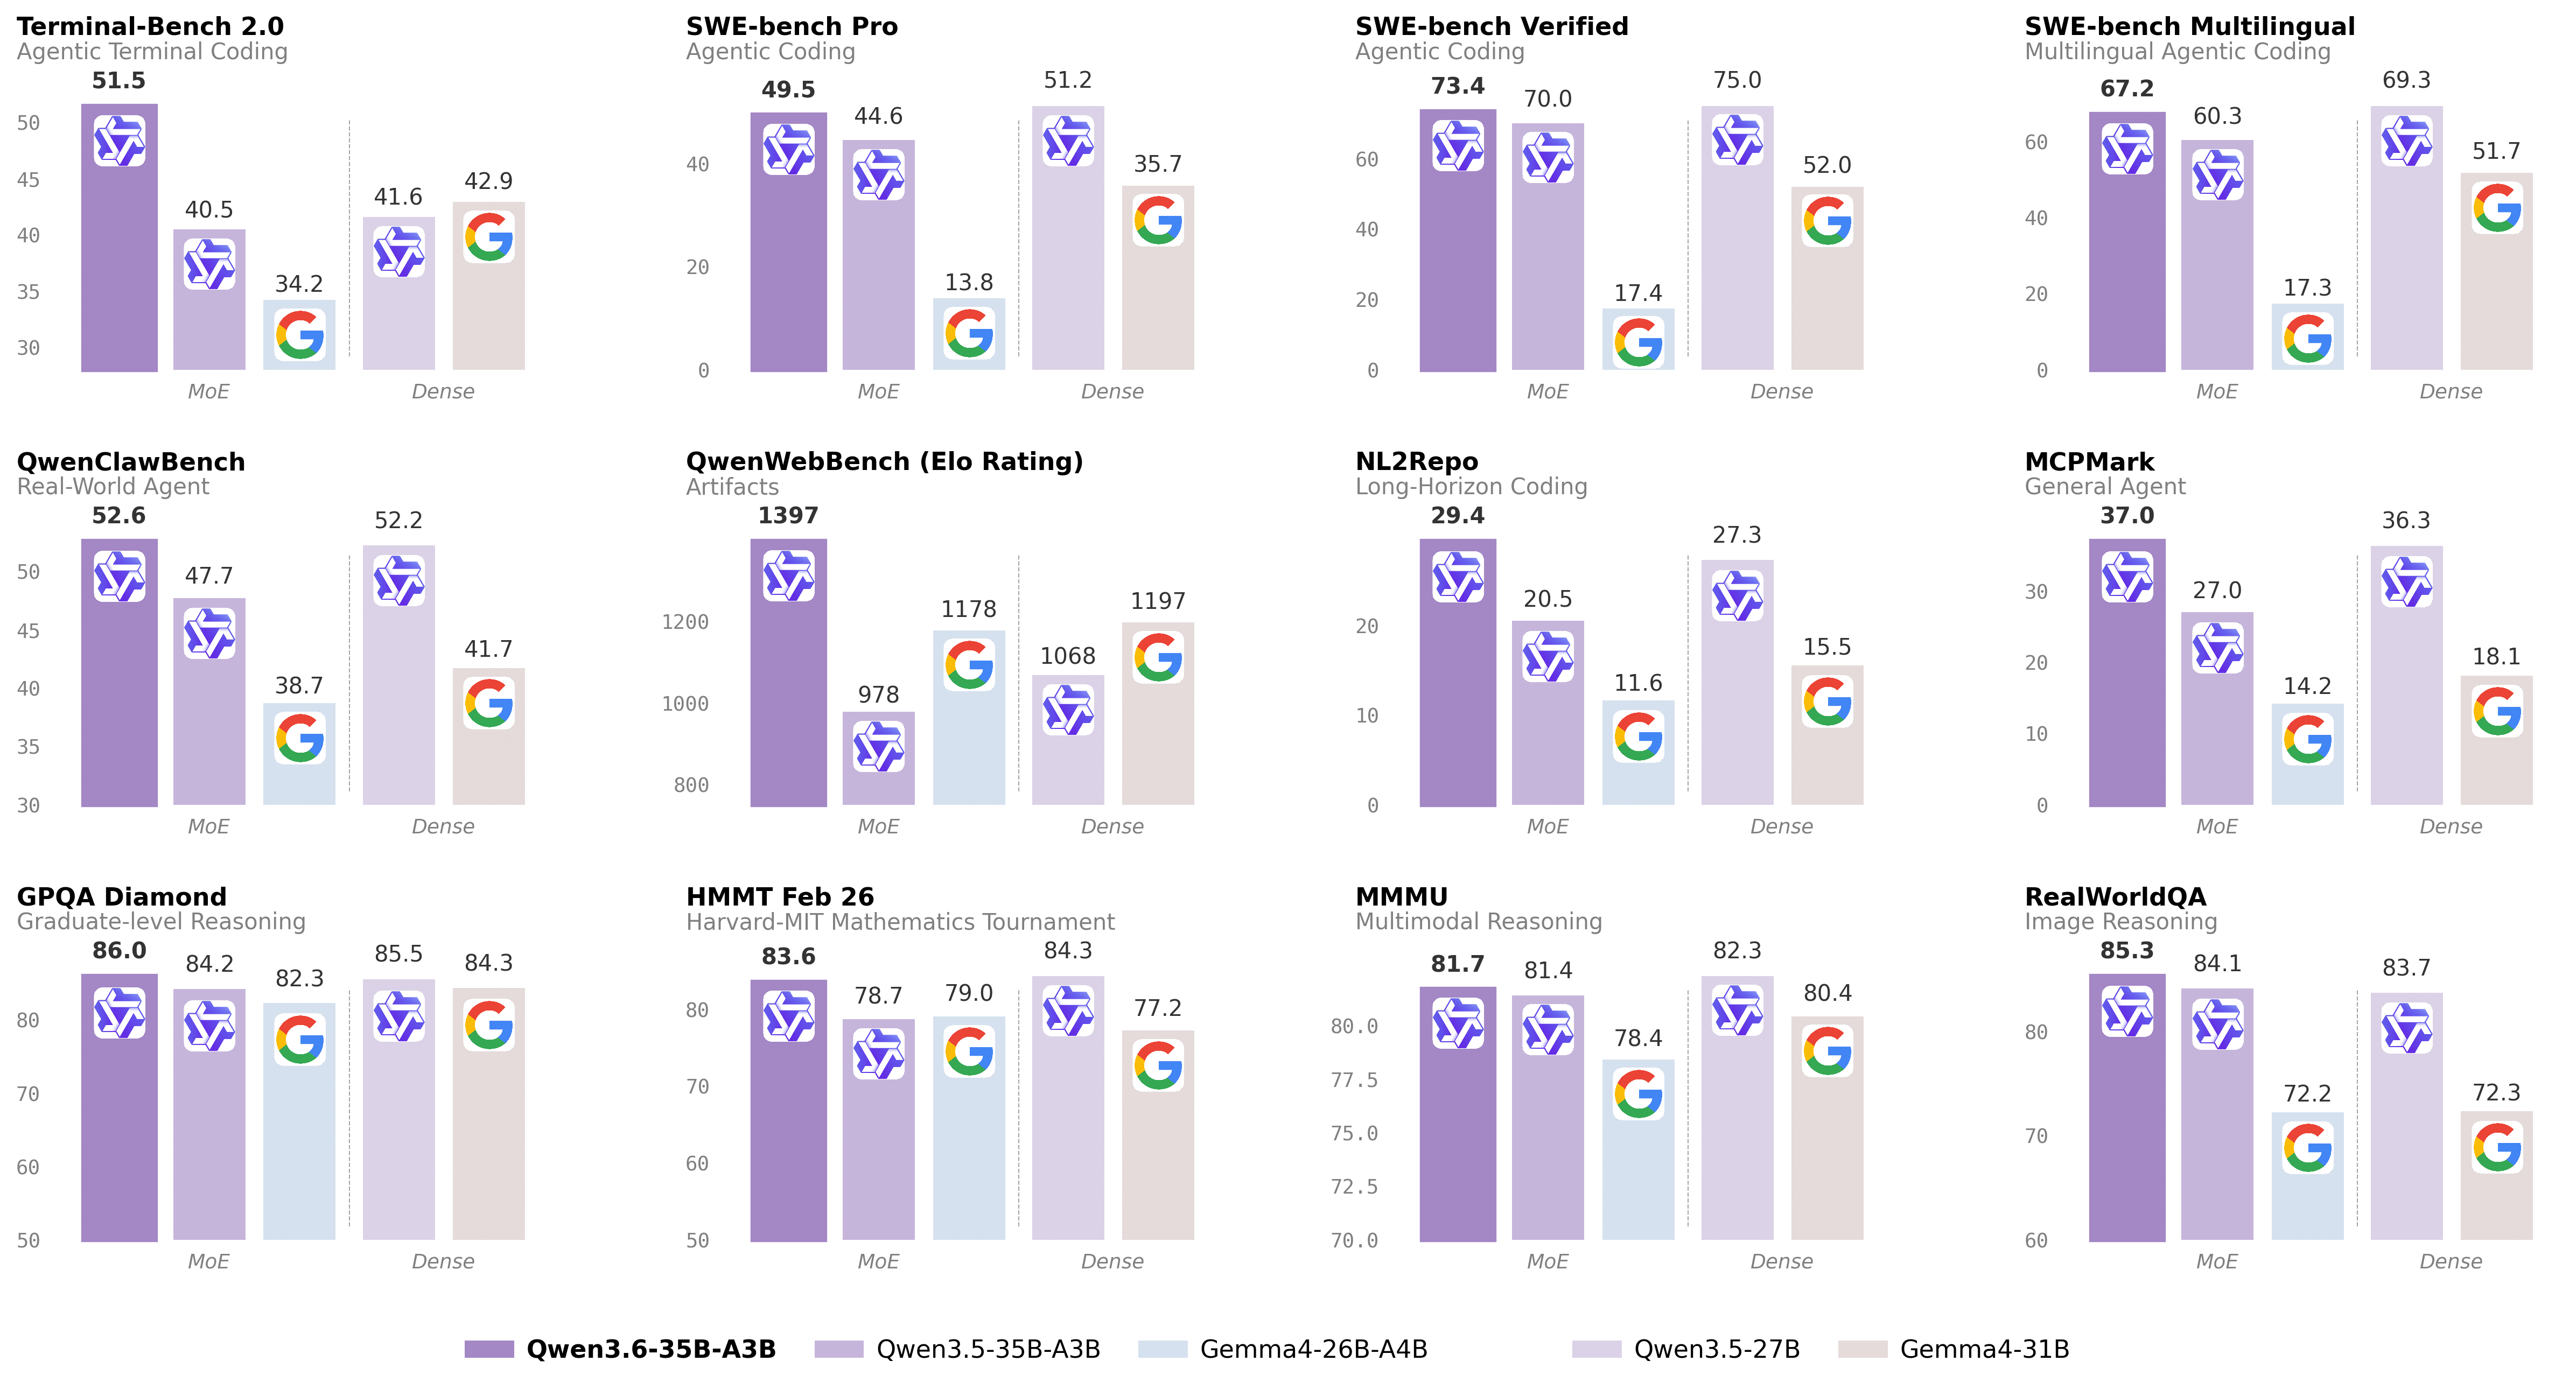
- 모델은 MoE 구조와 Gated DeltaNet/Gated Attention 블록 조합을 사용해 내부 연산 경로를 세분화하고, 각기 다른 헤드·차원 구성을 통해 시각-언어 및 텍스트 추론에 특화된 연산을 수행하도록 설계되었다. 이 구조적 선택은 멀티모달 이해와 STEM·추론 벤치에서의 성능 경쟁력을 뒷받침한다. 문서에서 제시된 레이어 구성과 헤드 차원은 이 설계의 구체적 근거를 제공한다.
- 서빙 관점에서 vLLM, SGLang, cute-DSL/CUTLASS/flashinfer_trtllm 등 특정 런타임과의 조합을 권장하며, 잘못된 백엔드 선택(예: Marlin) 시 성능이 크게 저하된다는 실험적 근거를 README가 명시하고 있다. 이 점은 단순 모델 성능뿐 아니라 전체 추론 스택의 선택이 실사용 처리량에 결정적 영향을 미친다는 실무적 사실을 보여준다. 따라서 사용자는 모델 선택뿐 아니라 추론 엔진 및 하드웨어 설정까지 염두에 둬야 한다.
- NVFP4 Fast 체크포인트는 동일 계열 NVFP4 양자화 대비 높은 처리량을 보이며 35B-A3B 구성에서 README의 벤치마크는 1.79배 처리량 개선을 보고하고 있다. 이 개선은 토큰 처리량 수치와 end-to-end thr out 수치에 근거한다. 따라서 비용 민감한 대규모 추론 환경에서 유리한 선택지가 된다.
벤치마크
| 벤치마크 | 지표 | 값 | 비교 |
|---|---|---|---|
| NVFP4 Throughput (35B-A3B) | throughput | 11,628 (Unsloth NVFP4 Fast) | vs NVIDIA: 6,481 (reported in README throughput chart); 1.79x faster |
| MMLU-Pro | accuracy | 85.85 (Unsloth NVFP4) | vs FP8 85.75; vs NVIDIA NVFP4 85.60 |
| GPQA | accuracy | 86.74 (Unsloth NVFP4) | vs NVIDIA NVFP4 87.12; vs BF16 86.36 |
| AIME 2025 | accuracy | 92.29 (Unsloth NVFP4) | vs FP8 93.12; vs NVIDIA NVFP4 91.88 |
이미지 분석

80
LIKES
217.4k
DOWNLOADS
1 / 0
조회수
관련 토론
아직 관련 토론이 없습니다.
댓글
댓글을 작성하려면 로그인이 필요합니다.

